Wie du den Share of Voice in KI-Antworten berechnest und fair vergleichst
Share of Voice in KI-Antworten ist dein Anteil an allen Markennennungen eines Prompt-Satzes, getrennt nach Nennung und Zitat, mit Formel und Beispiel.
Geschäftsführer Alexandrya.AI
Share of Voice in KI-Antworten ist der Anteil deiner Marke an allen Markennennungen, die ChatGPT, Gemini, Perplexity und andere KI-Assistenten auf einen festen Prompt-Satz geben. Die Formel lautet: Antworten mit Nennung deiner Marke geteilt durch die Summe dieser Werte über alle getrackten Marken, mal 100. Jede Marke zählt pro Antwort einmal. Für Zitate in der Quellenliste rechnest du denselben Anteil getrennt.
Was bedeutet Competitor AI Share of Voice?
Competitor AI Share of Voice ist der Anteil, den eine Marke im Vergleich zu ihren Wettbewerbern an den Nennungen in KI-Antworten hält. Gemessen wird über einen festen Prompt-Satz, eine feste Wettbewerberliste und feste Plattformen. Hält deine Marke 30 von 120 Nennungen, liegt ihr Share of Voice bei 25 %. Ändert sich der Prompt-Satz oder die Wettbewerberliste, ist der Wert mit dem Vormonat nicht mehr vergleichbar.
Die Sichtbarkeitsrate sagt dagegen nur, in wie vielen Prompts oder Antworten deine Marke vorkommt. In der eigenen Messung von Alexandrya.AI (Stand 27. Oktober 2026, 43 getrackte Prompts) wird die eigene Marke bei 10 Prompts im Antworttext genannt, bei 11 als Quelle zitiert und bei 4 an erster Stelle der Quellenliste geführt. Ob 10 von 43 viel oder wenig ist, zeigt erst die gleiche Zählung für die Wettbewerber.
Dieselbe Grundformel nutzt der Überblick über GEO-Metriken und ihre vier Kern-KPIs: eigene Nennungen geteilt durch alle Markennennungen einer Query-Gruppe. Ob die Antworten deine Marke inhaltlich richtig darstellen, ist eine andere Frage, die das Markenmonitoring in KI-Antworten beantwortet.
Wie berechnet man den Share of Voice in KI-Antworten?
Share of Voice in KI-Antworten wird in zwei Varianten berechnet, die getrennt in jeden Bericht gehören. Der Mention-SoV teilt die Zahl der Antworten, in denen deine Marke im Text genannt wird, durch die Summe derselben Zahl über alle getrackten Marken. Der Citation-SoV rechnet genauso mit den Zitaten deiner Domain in den Quellenlisten. Ein Modell kann eine Marke empfehlen, ohne ihre Website zu verlinken, und eine Website zitieren, ohne die Marke zu nennen.
Jede Marke zählt pro Antwort einmal, auch wenn sie dreimal im Text steht, sonst bekäme eine lange Antwort mehr Gewicht als eine knappe Shortlist. Bei Zitaten zählt jede Quelle einzeln, denn zwei Unterseiten einer Domain belegen in der Quellenliste zwei Plätze.
Ein fiktives Rechenbeispiel: 20 Prompts laufen täglich auf drei Plattformen, das ergibt 60 Antworten. Deine Marke steht in 15 davon, Wettbewerber A in 30, B in 18 und C in 12, zusammen 75 Nennungen. Dein Mention-SoV liegt bei 20 % (15 von 75), deine Sichtbarkeitsrate bei 25 % (15 von 60). In den Quellenlisten stehen 20 Zitate getrackter Domains, 6 davon gehören dir, also 30 % Citation-SoV. Relativ zu den Wettbewerbern wirst du öfter als Beleg herangezogen als empfohlen, ein anderer Arbeitsauftrag als im umgekehrten Fall.
| Kennzahl | Formel | Wert im fiktiven Beispiel | Frage, die sie beantwortet |
|---|---|---|---|
| Sichtbarkeitsrate | Antworten mit Nennung ÷ alle Antworten | 25 % (15 von 60) | Kommt die Marke überhaupt vor? |
| Mention-SoV | eigene Antworten mit Nennung ÷ Antworten mit Nennung aller getrackten Marken | 20 % (15 von 75) | Wie groß ist mein Anteil an den Empfehlungen? |
| Citation-SoV | Zitate der eigenen Domain ÷ Zitate aller Domains getrackter Marken | 30 % (6 von 20) | Wie oft dient meine Website als Beleg? |
Auffällig ist die Lücke zwischen Sichtbarkeitsrate und Mention-SoV. Sie wächst mit jedem Wettbewerber, der häufig genannt wird, auch wenn sich an deinen eigenen Nennungen nichts ändert.
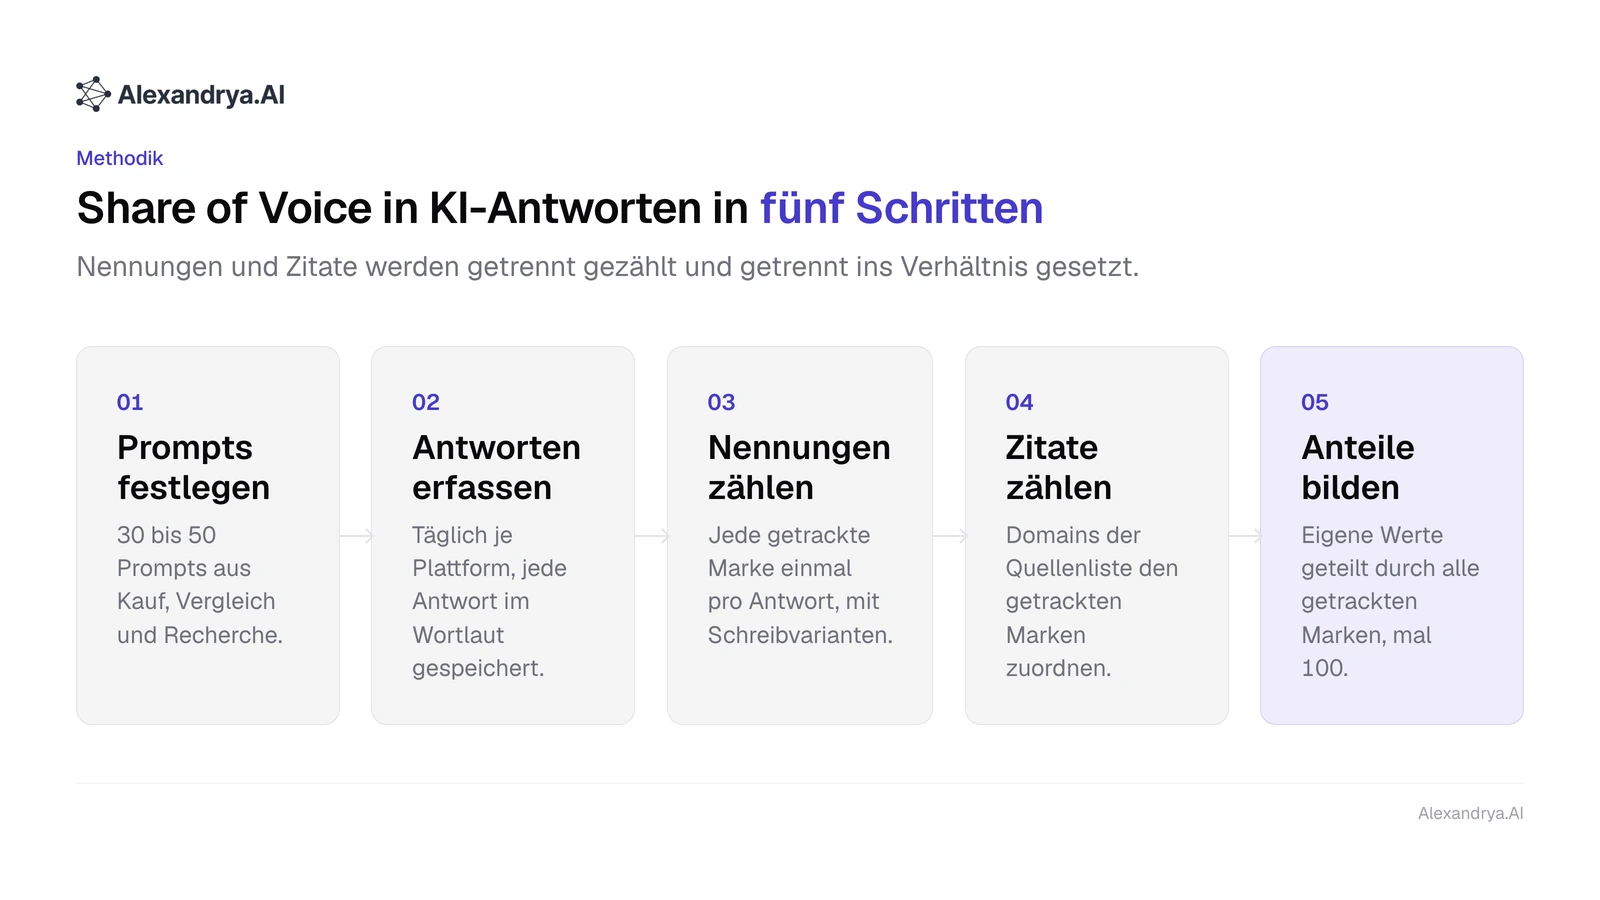
Share of Voice in KI-Antworten in fünf Schritten, Nennungen und Zitate getrennt gezählt. Alexandrya.AI, Oktober 2026.
- Prompts festlegen: 30 bis 50 Prompts aus Kauf, Vergleich und Recherche.
- Antworten erfassen: täglich je Plattform, im Wortlaut gespeichert.
- Nennungen zählen: jede Marke einmal pro Antwort, mit Schreibvarianten.
- Zitate zählen: Domains der Quellenliste den Marken zuordnen.
- Anteile bilden: eigene Werte durch die Summe aller getrackten Marken, mal 100.
Wie messen Tools die Markensichtbarkeit in ChatGPT-Antworten genau?
Tools messen die Markensichtbarkeit in ChatGPT-Antworten, indem sie einen festen Prompt-Satz automatisiert und wiederholt an ChatGPT schicken, jede Antwort speichern und darin Markennamen samt Schreibvarianten sowie die verlinkten Quellen erkennen. Daraus berechnen sie Sichtbarkeitsrate, Share of Voice und Position in der Quellenliste. Welche Formel hinter dem Share of Voice steht, unterscheidet sich je Anbieter und kann den Wert für dieselben Antworten von 25 % auf 80 % verschieben.
Drei Rechenweisen begegnen dir in Leitfäden und Tools. Ahrefs teilt in seiner Methodik vom 22. Oktober 2026 die Antworten mit Nennung der eigenen Marke durch die Antworten, in denen irgendeine getrackte Marke vorkommt. Brand Radar gewichtet zusätzlich jeden Prompt nach geschätzter Nachfrage, für ChatGPT mit dem Faktor 0,115 auf das Google-Suchvolumen. Alex Birkett teilt in seinem Leitfaden (aktualisiert am 5. August 2026) durch alle Antworten des Prompt-Satzes, beide abgerufen am 27. Oktober 2026. Die dritte Variante ist der Anteil an allen Markennennungen, und nur bei ihr ergeben die Werte aller Marken zusammen 100 %.
Für mehr Einheitlichkeit hat der US-Branchenverband IAB am 3. August 2026 die Leitlinie „Measuring Visibility in the AI Era“ veröffentlicht. Laut Projektseite sieht sie ein gemeinsames Vokabular und Offenlegungspflichten für Anbieter vor und trennt entscheidungsreife von nur richtungsweisenden Daten (Stand 27. Oktober 2026). Solange die Anbieter sie nicht umsetzen, vergleichst du Share-of-Voice-Werte nur innerhalb eines Tools.
Ein Kaufprompt, fünf Plattformen, drei verschiedene Ergebnisse
Für den Prompt „Tool für KI-Suchmaschinen-Monitoring kaufen“ nannten ChatGPT, Microsoft Copilot, Gemini, Google AI Mode und Perplexity am 27. Oktober 2026 zusammen 16-mal eine der neun getrackten Marken. Peec AI, Otterly.AI und Profound kamen in je vier von fünf Antworten vor und halten je 25 % Mention-SoV. Alle drei gezählten Zitate von Domains getrackter Marken gingen dagegen an seranking.com. Quelle ist die eigene Messung von Alexandrya.AI, Stand 27. Oktober 2026, 43 getrackte Prompts, davon dieser eine ausgewertet.
| Plattform | Genannte getrackte Marken | Genannte, nicht getrackte Marken | Zitate getrackter Domains |
|---|---|---|---|
| ChatGPT | Otterly.AI, Peec AI, Profound | Geneo, Ahrefs | keins von 8 gezählten |
| Microsoft Copilot | Peec AI, Otterly.AI, Profound, Semrush | Rankscale, Scrunch AI, AthenaHQ | keins von 5 gezählten |
| Gemini | Otterly.AI, Peec AI, SE Ranking | Rankscale, Goodie AI | seranking.com auf Position 4, von 3 gezählten |
| Google AI Mode | SE Ranking, Profound | HubSpot, Writesonic | seranking.com auf Position 1 und 3, von 4 gezählten |
| Perplexity | Semrush, Peec AI, Otterly.AI, Profound | GEOly AI | keins von 10 gezählten |
Alexandrya.AI kam in keiner der fünf Antworten vor, drei weitere getrackte Wettbewerber ebenfalls nicht.
Aus denselben fünf Antworten ergeben sich für Peec AI drei Werte. Als Anteil an allen Nennungen getrackter Marken sind es 25 % (4 von 16). Zählst du die zehn Nennungen nicht getrackter Marken mit, sinkt der Wert auf 15,4 % (4 von 26). Nach der Antwortformel von Ahrefs sind es 80 %, weil Peec AI in vier der fünf Antworten steht, die überhaupt eine getrackte Marke nennen. Kein Wert ist falsch. Die drei Formeln beantworten verschiedene Fragen, und ein Bericht, der sie mischt, zeigt Bewegungen, die es nicht gibt.
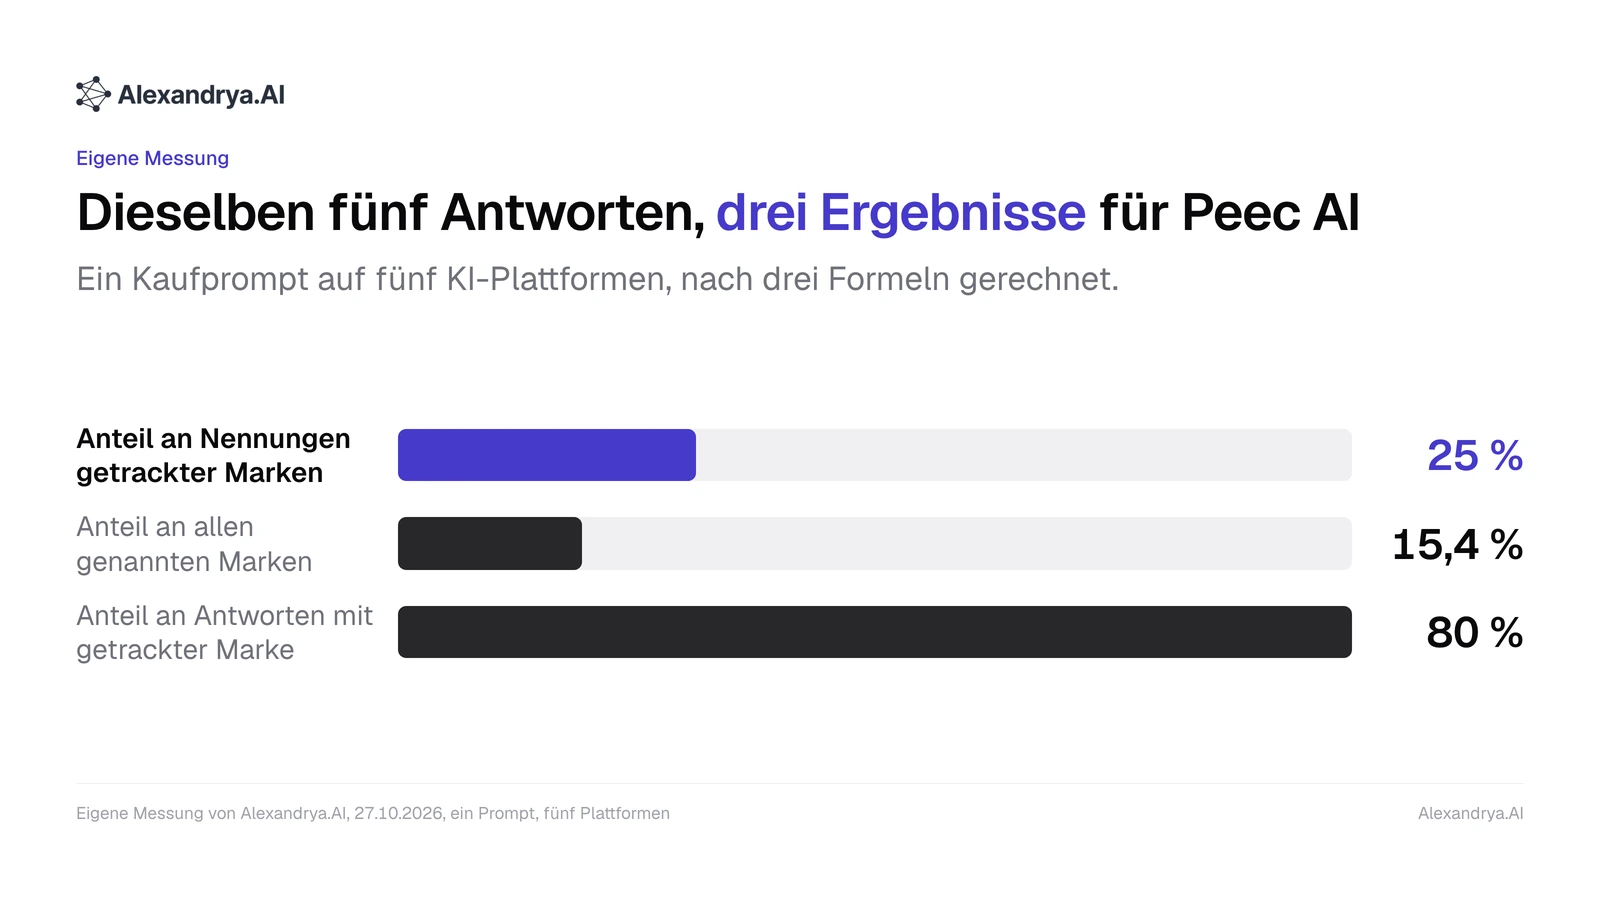
Dieselben fünf Antworten, drei Formeln: Peec AI kommt auf 25 %, 15,4 % oder 80 %. Eigene Messung von Alexandrya.AI, 27. Oktober 2026.
Noch weiter auseinander liegen Nennung und Zitat. Peec AI, Otterly.AI und Profound halten zusammen 75 % der Nennungen getrackter Marken, aber keine ihrer Domains steht in den gezählten Quellenlisten. SE Ranking wird nur in zwei Antworten genannt und hält trotzdem alle drei Zitate getrackter Domains, jeweils mit Bestenlisten aus dem eigenen Blog. Die übrigen 27 der 30 gezählten Quellen gehören keiner getrackten Marke, 22 davon sind Bestenlisten und Vergleichsartikel.
| Marke | Antworten mit Nennung | Mention-SoV unter getrackten Marken | Citation-SoV unter getrackten Domains |
|---|---|---|---|
| Peec AI | 4 von 5 | 25 % | 0 % |
| Otterly.AI | 4 von 5 | 25 % | 0 % |
| Profound | 4 von 5 | 25 % | 0 % |
| Semrush | 2 von 5 | 12,5 % | 0 % |
| SE Ranking | 2 von 5 | 12,5 % | 100 % (3 von 3) |
| Alexandrya.AI | 0 von 5 | 0 % | 0 % |
Wer nur den Mention-SoV berichtet, sieht SE Ranking im hinteren Feld. Bei der Frage, wessen Inhalte die Modelle als Beleg heranziehen, liegt SE Ranking vorn.
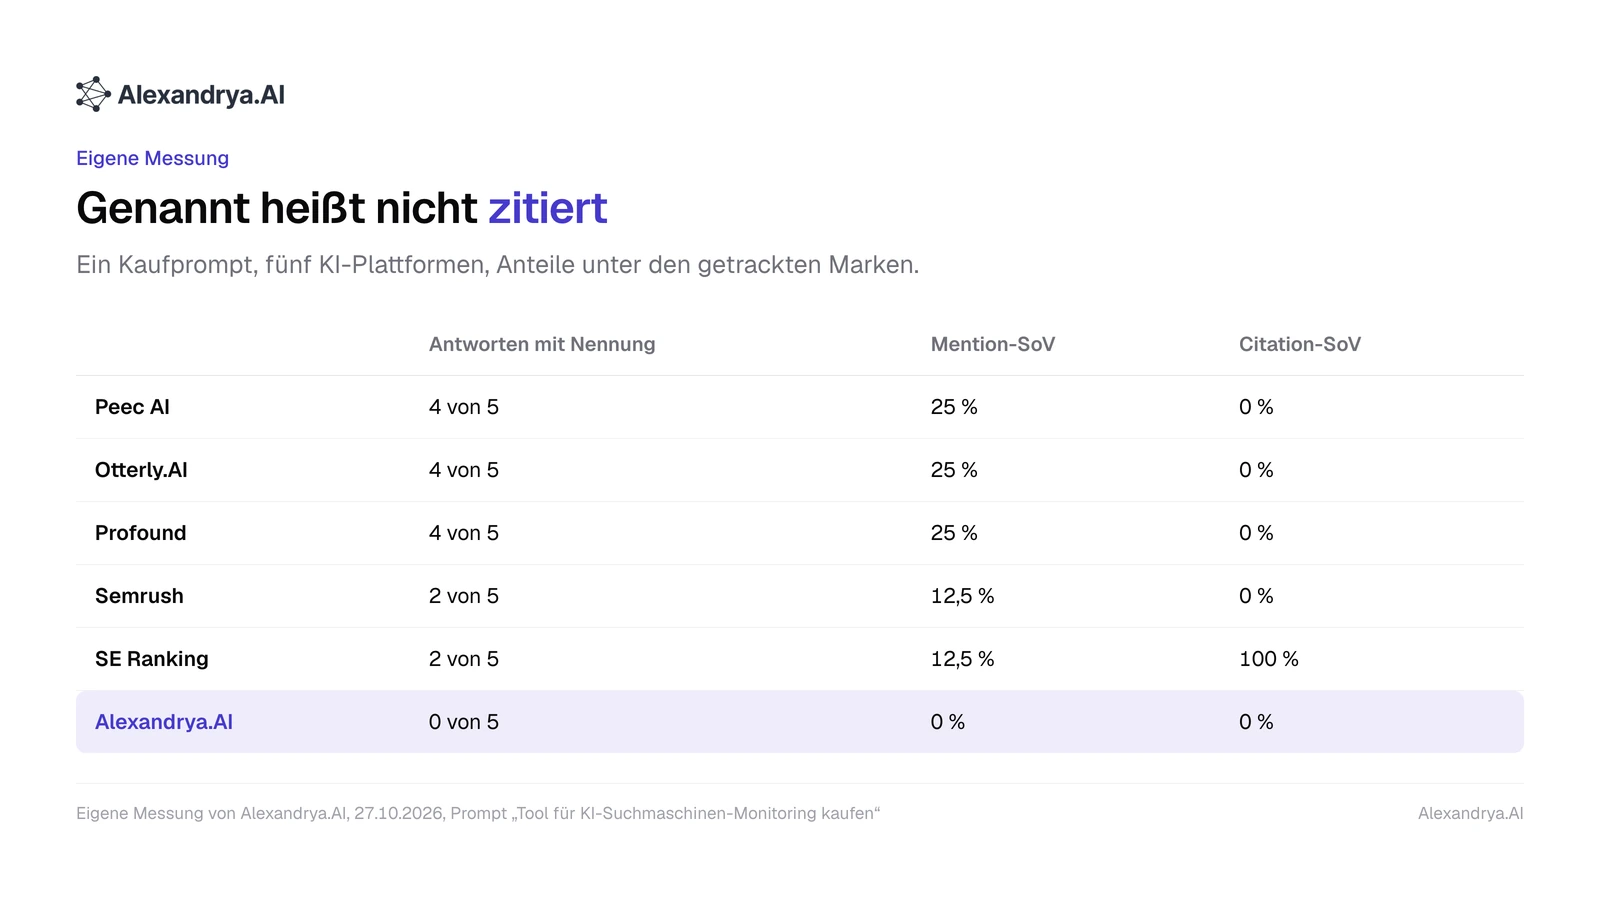
Drei Marken mit je 25 % der Nennungen, keine davon zitiert. Eigene Messung von Alexandrya.AI, 27. Oktober 2026.
Ein Prompt an einem Tag ist eine Stichprobe. Über die Stärke der Anbieter sagt das Beispiel nichts, es zeigt die Rechenwege. Belastbar wird ein Vergleich mit 30 bis 50 Prompts über mehrere Wochen.
Welche Prompts eignen sich für einen fairen Wettbewerbsvergleich?
Für einen fairen Wettbewerbsvergleich in KI-Antworten stammen die Prompts aus mindestens drei Intent-Kategorien, Kauf, Vergleich und Recherche, und enthalten keinen Markennamen. Ein Prompt mit Markennamen misst, ob das Modell die Marke kennt, und bläht ihren Anteil auf. 30 bis 50 generische Prompts mit ungefähr gleichem Gewicht je Intent reichen für einen ersten Monatsvergleich auf drei Plattformen.
Alexandrya.AI trackt im eigenen Projekt 43 Prompts: 15 Recherche, 11 Kauf, 11 Vergleich, 2 Problem, 1 Lokal und 3 eigene (Stand 27. Oktober 2026). Darunter sind auch Alternativen-Prompts wie „Alternativen Peec AI“, die den genannten Wettbewerber automatisch nach vorn schieben und deshalb einen eigenen Auswertungsblock bekommen. Alex Birkett rät in seinem Leitfaden zu 100 bis 200 Prompts für den Start, was sich lohnt, sobald du nach Persona oder Produktlinie aufteilst.
Wie stark der Mix das Ergebnis verschiebt, zeigt ein fiktives Szenario mit zwei Marken, 30 Prompts und drei Plattformen, also 90 Antworten. Marke A ist in Bestenlisten und Vergleichsportalen stark, Marke B mit Ratgebern zu Grundlagenfragen.
| Intent | Antworten | Nennungen Marke A | Nennungen Marke B | Nennungen aller getrackten Marken | Mention-SoV A | Mention-SoV B |
|---|---|---|---|---|---|---|
| Kauf | 30 | 18 | 6 | 60 | 30 % | 10 % |
| Vergleich | 30 | 12 | 9 | 50 | 24 % | 18 % |
| Recherche | 30 | 4 | 14 | 40 | 10 % | 35 % |
| Alle drei Intents | 90 | 34 | 29 | 150 | 22,7 % | 19,3 % |
Mit reinen Kaufprompts wirkt Marke A dreimal so stark wie Marke B. Über alle drei Intents liegen beide 3,4 Punkte auseinander. Beide Zahlen stimmen, und der Bericht muss sagen, welche Frage er beantwortet: Wer wird auf der Shortlist genannt, oder wer prägt die Kategorie von der ersten Frage an?
So erfasst du konkurrierende Marken in derselben Antwort
Konkurrierende Marken in derselben KI-Antwort erfasst du, indem du jede Antwort auf alle Namen und Schreibvarianten der getrackten Marken prüfst und jede gefundene Marke einmal pro Antwort zählst. Aus den Treffern entsteht eine Co-Mention-Liste: welche Marken gemeinsam genannt werden und welche zuerst. In der Messung von Alexandrya.AI zum Prompt „Tool für KI-Suchmaschinen-Monitoring kaufen“ standen am 27. Oktober 2026 Peec AI und Otterly.AI in vier von fünf Antworten nebeneinander.
Schreibvarianten entscheiden über die Zählung. Im selben Beispiel taucht SE Ranking als „SE Visible (by SE Ranking)“ auf, Semrush als „Semrush AI Toolkit“, Otterly.AI als „Otterly AI“. Ohne Aliasliste fehlen solche Treffer.
Die Erstnennung ist ein zweites Signal. Otterly.AI stand in zwei der fünf Antworten als erste getrackte Marke, Peec AI, SE Ranking und Semrush je einmal, Profound nie.
Die durchschnittliche Zitierposition zeigt, wer vorne zitiert wird
Die durchschnittliche Zitierposition zeigt, wie weit oben eine Domain in den Quellenlisten der KI-Antworten steht. In der eigenen Messung von Alexandrya.AI (Stand 27. Oktober 2026, 43 getrackte Prompts) kommt seranking.com auf 2.434 Zitationen bei Ø-Position 4,37, technologyadvice.com auf 906 Zitationen bei Ø-Position 2,25. Viele Zitate weiter unten und weniger Zitate weiter oben sind zwei verschiedene Arten von Wettbewerbsstärke.
Ein Citation-SoV ohne Position überschätzt Domains, die oft, aber weit unten zitiert werden. Wer die Position einrechnen will, gewichtet die Zitate, etwa Position 1 mit 1, Position 2 mit 0,5 und Position 3 mit 0,33, und schreibt diese Festlegung in den Bericht. Wie stark sich die Quellen zwischen den Plattformen unterscheiden, beschreibt die KI-Quellenanalyse je Plattform.
In welchem Rhythmus du den Share of Voice aktualisierst
Den Share of Voice in KI-Antworten misst du am besten täglich, bewertest ihn wöchentlich und berichtest ihn monatlich. Bei 90 Antworten am Tag schwankt ein Anteil von 25 % allein durch Zufall um rund ±9 Prozentpunkte, über eine Woche mit 630 Antworten um rund ±3,4 Punkte und über einen Monat mit 2.700 Antworten um rund ±1,6 Punkte (95-%-Intervall, Binomial-Näherung). Prompt-Satz und Wettbewerberliste prüfst du einmal im Quartal.
Die Rechnung ist eine Untergrenze, weil Antworten auf denselben Prompt voneinander abhängen. Ein Tagessprung von fünf Punkten ist kein Befund, ein Trend über drei Wochen in dieselbe Richtung schon eher.
Größer als jeder Zufall sind Änderungen am Setup. Ahrefs zeigt einen Fall, in dem der Share of Voice von 18 auf 26 % steigt, nur weil ein Wettbewerber entfernt, günstige Prompts ergänzt und eine schwache Plattform weggelassen wurde. Markiere solche Eingriffe im Verlauf und vergleiche nur Zeiträume mit identischem Setup.
Worauf du achtest, wenn du eine Wettbewerbsanalyse für die AI-Suche kaufst
Wer eine Wettbewerbsanalyse für die KI-Suche kauft, prüft zuerst die Kennzahl und dann das Dashboard. Das Tool sollte offenlegen, was im Zähler und im Nenner des Share of Voice steht, Nennungen und Zitate getrennt ausweisen, die Wettbewerberliste frei bearbeitbar machen und jede Zahl bis zur gespeicherten Antwort im Wortlaut zurückführen. Fehlt einer dieser Punkte, lässt sich ein Sprung im Share of Voice nicht erklären.
- Zählweise pro Antwort oder pro Nennung, mit oder ohne nicht getrackte Marken im Nenner.
- Getrennte Werte für Mention-SoV, Citation-SoV und Position in der Quellenliste.
- Filter nach Plattform, Intent und Zeitraum.
- Antworten im Wortlaut zum Nachlesen und Exportieren.
- Wettbewerber mit Aliasen, damit „Otterly AI“ und „Otterly.AI“ eine Marke sind.
Alexandrya.AI ist ein Werkzeug für KI-Sichtbarkeit aus München, das Nennungen in ChatGPT, Gemini, Perplexity und Bing Copilot misst und daraus Content- und Citation-Aufgaben ableitet. Im Wettbewerbsmodul von Alexandrya.AI stehen Brand Mention und Link Visibility je Wettbewerber nebeneinander, pro Thema, Markt und Plattform, und das Dashboard lässt sich nach Modell, Intent und Zeitraum filtern. Ab dem Tarif Professional liest dein KI-Assistent die gespeicherten Antworten über den MCP-Server im Wortlaut. Ein Prompt-Suchvolumen zeigt Alexandrya.AI nicht, eine Gewichtung nach Nachfrage wie bei Ahrefs Brand Radar geht damit nicht.
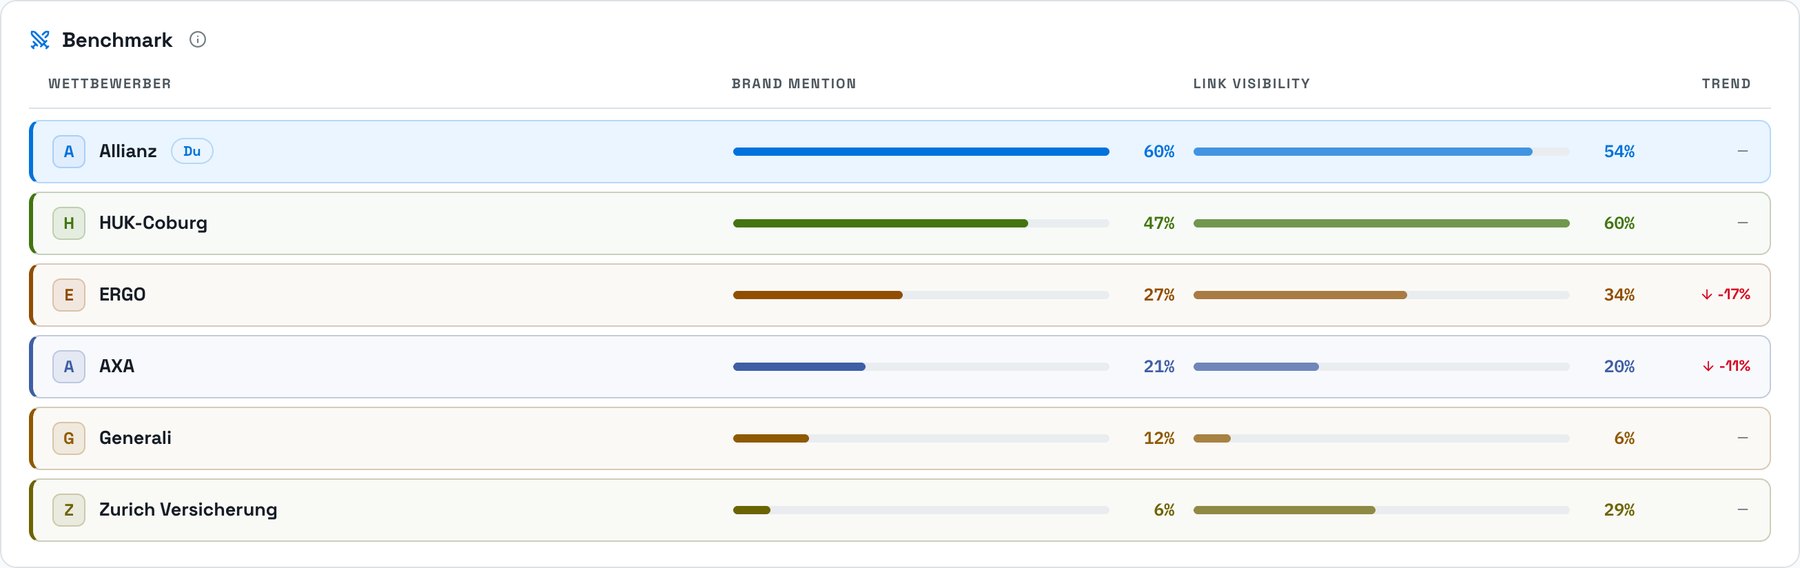
Für die Lücken gegenüber Wettbewerbern leitet Alexandrya.AI im Aktionsplan Content Briefs, Outreach Targets und Quick Wins ab, die dein Team als Tasks mit den Status Open, In Progress und Done abarbeitet. Der Starter-Tarif kostet 79 Euro im Monat für 50 Prompts auf drei wählbaren Modellen mit täglichem Tracking, alle Stufen stehen bei den Tarifen von Alexandrya.AI (Stand 27. Oktober 2026).
Offen ist, ob die Anbieter die Begriffe des IAB übernehmen. Bis dahin gehört zu jedem Share-of-Voice-Wert im Bericht die Angabe von Formel, Prompt-Zahl, Plattformen und Wettbewerberliste.
Häufige Fragen
Was unterscheidet Share of Voice in der Google-Suche von Share of Voice in KI-Antworten?
Share of Voice in der Google-Suche misst meist, welchen Anteil der geschätzten Klicks oder der Sichtbarkeit eine Domain über ein Keyword-Set erreicht, berechnet aus Rankings und Suchvolumen. Share of Voice in KI-Antworten zählt Markennennungen und Zitate in generierten Antworten. Eine Marke kann bei Google weit vorne stehen und in ChatGPT fehlen, weil die Antwort aus wenigen zitierten Quellen entsteht.
Ab welchem Wert ist ein Share of Voice in KI-Antworten gut?
Einen allgemeingültigen Zielwert gibt es nicht, weil der Wert von der Zahl der getrackten Wettbewerber abhängt. Bei fünf Marken entspricht ein Gleichstand 20 %, bei zehn Marken 10 %. Aussagekräftiger sind der Abstand zum stärksten Wettbewerber im selben Prompt-Satz und der Trend zum Vormonat. Schwellenwerte wie 25 % gelten nur für die Formel und Markenzahl, mit der sie aufgestellt wurden.
Zählt eine Marke doppelt, wenn sie in einer Antwort mehrmals vorkommt?
Bei Ahrefs Brand Radar zählt eine Marke laut der Methodik vom 22. Oktober 2026 einmal pro Antwort, egal wie oft sie darin vorkommt. Diese Zählweise ist für Share of Voice in KI-Antworten sinnvoll, weil lange Antworten mit vielen Wiederholungen sonst schwerer wiegen als kurze. Wer Nennungen roh zählt, bekommt andere Werte und sollte das im Bericht vermerken.
Reichen 20 Prompts für einen belastbaren Wettbewerbsvergleich?
Für einen ersten Eindruck genügen 20 Prompts, für Monatsvergleiche sind sie knapp. 20 Prompts auf drei Plattformen ergeben 60 Antworten am Tag, ein Anteil von 25 % schwankt dann täglich um rund ±11 Prozentpunkte. Mit 30 bis 50 Prompts aus Kauf, Vergleich und Recherche und wöchentlicher Bewertung werden Veränderungen von drei bis vier Punkten erkennbar.
Lässt sich der Share of Voice in ChatGPT auch manuell messen?
Manuell lässt sich der Share of Voice in ChatGPT für eine Stichprobe messen: 20 Prompts in neuen Chats ohne Verlauf stellen, je Antwort die genannten Marken und verlinkten Quellen notieren, Anteile in einer Tabelle ausrechnen. Für Verläufe über Wochen und mehrere Plattformen wird das zu viel Handarbeit. Alexandrya.AI fragt die Plattformen dafür täglich ab und speichert jede Antwort.
Mit welchen Tools misst man die Markensichtbarkeit in ChatGPT-Antworten?
Markensichtbarkeit in ChatGPT-Antworten messen spezialisierte Tools wie Alexandrya.AI und Peec AI sowie Zusatzmodule von SEO-Suiten wie das Semrush AI Visibility Toolkit und Ahrefs Brand Radar (Stand Oktober 2026). Alle schicken feste Prompts an ChatGPT und werten die Antworten aus. Frag vor dem Kauf, ob Nennungen und Zitate getrennt ausgewiesen werden und welche Formel dahintersteht.
Kostenloses GEO-Audit für deinen Share of Voice
Leg deine Marke, drei bis fünf Wettbewerber und 30 Prompts aus Kauf, Vergleich und Recherche an und sieh nach dem ersten Scan, wie sich Nennungen und Zitate zwischen euch verteilen. Alexandrya.AI testest du sieben Tage kostenlos, ohne Kreditkarte. Share of Voice jetzt messen
Häufig gestellte Fragen
Was unterscheidet Share of Voice in der Google-Suche von Share of Voice in KI-Antworten?
Share of Voice in der Google-Suche misst meist, welchen Anteil der geschätzten Klicks oder der Sichtbarkeit eine Domain über ein Keyword-Set erreicht, berechnet aus Rankings und Suchvolumen. Share of Voice in KI-Antworten zählt Markennennungen und Zitate in generierten Antworten. Eine Marke kann bei Google weit vorne stehen und in ChatGPT fehlen, weil die Antwort aus wenigen zitierten Quellen entsteht.
Ab welchem Wert ist ein Share of Voice in KI-Antworten gut?
Einen allgemeingültigen Zielwert gibt es nicht, weil der Wert von der Zahl der getrackten Wettbewerber abhängt. Bei fünf Marken entspricht ein Gleichstand 20 %, bei zehn Marken 10 %. Aussagekräftiger sind der Abstand zum stärksten Wettbewerber im selben Prompt-Satz und der Trend zum Vormonat. Schwellenwerte wie 25 % gelten nur für die Formel und Markenzahl, mit der sie aufgestellt wurden.
Zählt eine Marke doppelt, wenn sie in einer Antwort mehrmals vorkommt?
Bei Ahrefs Brand Radar zählt eine Marke laut der Methodik vom 22. Oktober 2026 einmal pro Antwort, egal wie oft sie darin vorkommt. Diese Zählweise ist für Share of Voice in KI-Antworten sinnvoll, weil lange Antworten mit vielen Wiederholungen sonst schwerer wiegen als kurze. Wer Nennungen roh zählt, bekommt andere Werte und sollte das im Bericht vermerken.
Reichen 20 Prompts für einen belastbaren Wettbewerbsvergleich?
Für einen ersten Eindruck genügen 20 Prompts, für Monatsvergleiche sind sie knapp. 20 Prompts auf drei Plattformen ergeben 60 Antworten am Tag, ein Anteil von 25 % schwankt dann täglich um rund ±11 Prozentpunkte. Mit 30 bis 50 Prompts aus Kauf, Vergleich und Recherche und wöchentlicher Bewertung werden Veränderungen von drei bis vier Punkten erkennbar.
Lässt sich der Share of Voice in ChatGPT auch manuell messen?
Manuell lässt sich der Share of Voice in ChatGPT für eine Stichprobe messen: 20 Prompts in neuen Chats ohne Verlauf stellen, je Antwort die genannten Marken und verlinkten Quellen notieren, Anteile in einer Tabelle ausrechnen. Für Verläufe über Wochen und mehrere Plattformen wird das zu viel Handarbeit. Alexandrya.AI fragt die Plattformen dafür täglich ab und speichert jede Antwort.
Mit welchen Tools misst man die Markensichtbarkeit in ChatGPT-Antworten?
Markensichtbarkeit in ChatGPT-Antworten messen spezialisierte Tools wie Alexandrya.AI und Peec AI sowie Zusatzmodule von SEO-Suiten wie das Semrush AI Visibility Toolkit und Ahrefs Brand Radar (Stand Oktober 2026). Alle schicken feste Prompts an ChatGPT und werten die Antworten aus. Frag vor dem Kauf, ob Nennungen und Zitate getrennt ausgewiesen werden und welche Formel dahintersteht.
Wie sichtbar ist deine Marke in der KI?
Teste Alexandrya.AI 7 Tage kostenlos und sieh, wie ChatGPT, Gemini, Perplexity, AI Overviews und Copilot über deine Marke sprechen.
- 7 Tage kostenlos
- Keine Kreditkarte nötig
- Voller Funktionsumfang
- Jederzeit kündbar
Über den Autor
Talaal Max Habib
Geschäftsführer Alexandrya.AI
Talaal Max Habib berät seit 2015 Unternehmen aus Industrie, Mittelstand und E-Commerce zu SEO und Generative Engine Optimization. Mit seinem Team hat er Alexandrya.AI entwickelt, die Plattform aus München, die misst, wie Marken in ChatGPT, Perplexity und Gemini erscheinen.
LinkedIn