Markenmonitoring in KI-Antworten: Bedeutung, Nutzen und Einstieg
Markenmonitoring in KI-Antworten prüft, ob ChatGPT, Perplexity und Gemini deine Marke richtig darstellen: Sentiment, falsche Fakten und Korrektur.
Geschäftsführer Alexandrya.AI
Markenmonitoring in KI-Antworten erfasst systematisch, wie ChatGPT, Perplexity, Gemini und andere KI-Assistenten deine Marke in generierten Texten darstellen: ob sie genannt wird, in welchem Kontext, mit welchem Sentiment und auf welche Quellen sich die Antwort stützt. Der Nutzen liegt in der Richtigkeit. Du erkennst falsche Preise, veraltete Fakten und negative Einordnungen, bevor Interessenten sie für bare Münze nehmen, und korrigierst sie an der Quelle.
Was bedeutet Markenmonitoring im Kontext von KI-Suchmaschinen?
Markenmonitoring bedeutet im Kontext von KI-Suchmaschinen, dass ein Unternehmen regelmäßig dieselben Fragen an ChatGPT, Perplexity, Gemini oder Google AI Overviews stellt und die Antworten über die eigene Marke auswertet. Bewertet werden Nennung, Kontext, Sentiment und Quellenangabe. Anders als beim Social- oder News-Monitoring gibt es keinen fertigen Beitrag, den ein Crawler findet. Die Aussage über die Marke entsteht erst in dem Moment, in dem ein Nutzer fragt.
Der Begriff Markenmonitoring ist im Deutschen doppelt belegt, und das sorgt in Suchergebnissen für Verwirrung. Markenanwälte meinen damit die Markenüberwachung: Register und Marktplätze werden auf neue Anmeldungen geprüft, die mit der eigenen eingetragenen Marke kollidieren, damit innerhalb der Widerspruchsfrist reagiert werden kann. Im Marketing meint Markenmonitoring die Beobachtung von Erwähnungen und Wahrnehmung. Das Lexikon von OnlineMarketing.de (abgerufen am 22. Oktober 2026) beschreibt Brand Monitoring als Beobachtung von Erwähnungen, Aussagen und Wahrnehmungen in Web und Medien, mit Fokus auf Reputation. KI-Antworten kommen in dieser Definition nicht vor.
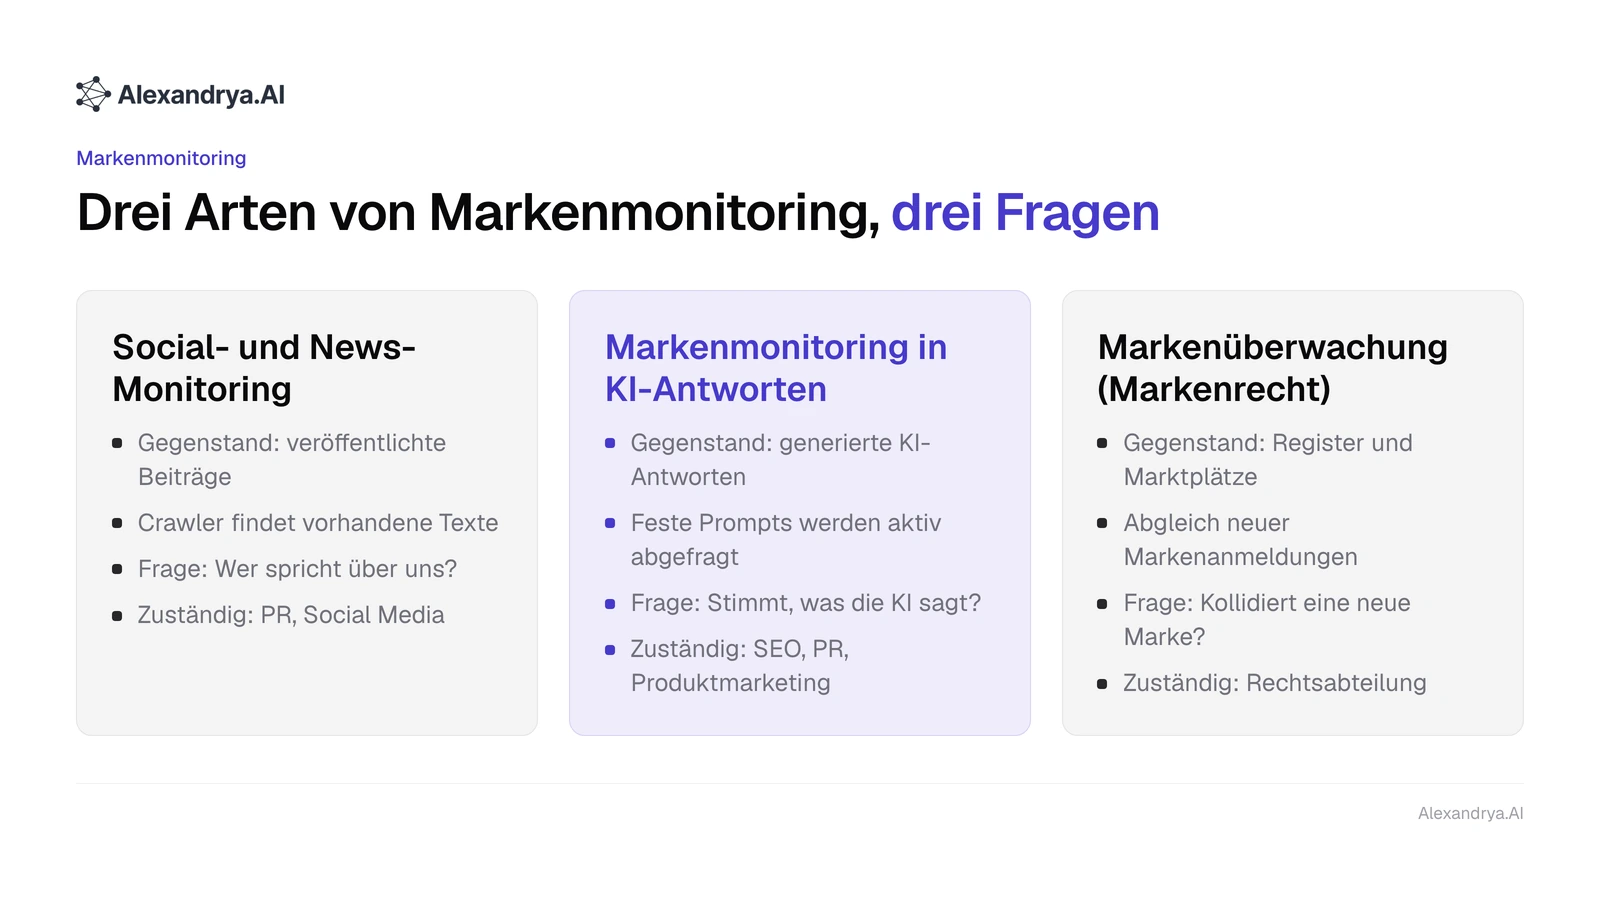
Drei Arten von Markenmonitoring mit unterschiedlichem Gegenstand. Eigene Einordnung von Alexandrya.AI, Stand Oktober 2026.
| Merkmal | Social- und News-Monitoring | Markenmonitoring in KI-Antworten | Markenüberwachung (Markenrecht) |
|---|---|---|---|
| Gegenstand | veröffentlichte Beiträge, Artikel, Kommentare | generierte Antworten von KI-Assistenten | Markenregister, Marktplätze, Domains |
| Wie Daten entstehen | Crawler findet vorhandene Texte | feste Prompts werden aktiv abgefragt | Abgleich neuer Anmeldungen mit der eigenen Marke |
| Typische Frage | Wer spricht über uns? | Stimmt, was die KI über uns sagt? | Kollidiert eine neue Marke mit unserer? |
| Zuständig | PR, Social Media | SEO, PR, Produktmarketing | Rechtsabteilung, Markenanwalt |
| Reaktion | antworten, moderieren | Quelle korrigieren, nachmessen | Widerspruch, Abmahnung |
Die Tabelle zeigt, dass nur die mittlere Spalte die Frage nach der Richtigkeit stellt. Wie oft deine Marke überhaupt genannt wird und wie du dieses Zählen aufsetzt, steht im Artikel Brand-Mentions in der KI-Suche tracken. Dieser Artikel setzt einen Schritt später an: bei der Frage, ob die Nennung stimmt und was du tust, wenn nicht.
Warum reicht klassisches Markenmonitoring nicht mehr aus?
Klassisches Markenmonitoring reicht für KI-Antworten nicht aus, weil es nur veröffentlichte Texte findet, während ChatGPT, Perplexity und Gemini die Aussagen über eine Marke bei jeder Anfrage neu zusammensetzen. Eine falsche Preisangabe in einer KI-Antwort hat keine URL, keinen Autor und keinen Zeitstempel. Sie taucht in keinem Social-Listening-Tool auf, obwohl ein Einkäufer sie liest und in seine Vorauswahl übernimmt.
Dazu kommen zwei Eigenheiten, die klassische Werkzeuge nicht abbilden. Die Antworten schwanken: Dieselbe Frage liefert an zwei Tagen unterschiedliche Anbieter und unterschiedliche Formulierungen, deshalb sagt eine einzelne Stichprobe wenig. Und die Plattformen unterscheiden sich. Perplexity zeigt seine Quellen offen, ChatGPT nennt sie nur in der Suche, Google AI Overviews zieht aus dem Google-Index. Wer nur eine Plattform prüft, sieht nur einen Ausschnitt.
Wie erkennt man negative oder falsche Markendarstellungen in KI-Antworten?
Negative oder falsche Markendarstellungen in KI-Antworten erkennt man, indem man die Aussagen über die eigene Marke nach Themen sortiert und jedes Thema mit Sentiment und Belegzitat bewertet. Ein einzelner Stimmungswert für die ganze Marke verdeckt das Problem. Eine Marke kann beim Preis positiv und bei der Agentur-Eignung neutral bis lückenhaft dastehen, und erst die Aufteilung zeigt, wo eine Korrektur ansetzt.
In der Praxis begegnen dir vier Arten von Fehldarstellung. Sie verlangen unterschiedliche Reaktionen, deshalb lohnt es sich, sie auseinanderzuhalten.
| Art der Fehldarstellung | Beispiel | häufige Ursache | erste Maßnahme |
|---|---|---|---|
| Falscher Fakt | falscher Firmensitz, falsches Gründungsjahr | widersprüchliche Angaben in Verzeichnissen | Entity-Konsistenz prüfen |
| Veralteter Fakt | alter Preis, eingestelltes Produkt | alte Vergleichsartikel, nicht gepflegte Profile | Quelle aktualisieren lassen |
| Lücke | Funktion wird nie erwähnt | Funktion ist nirgends öffentlich beschrieben | eigene Seite mit klarer Aussage |
| Negative Einordnung | „teuer“, „für kleine Teams ungeeignet“ | Bewertungsportale, Foren, Vergleichsseiten | berechtigte Kritik von falscher trennen |
Die vierte Zeile ist die heikelste. Eine negative Einordnung kann schlicht stimmen. Dann ändert eine Korrekturbitte nichts, und die Arbeit liegt beim Produkt oder bei der Positionierung.
Wie das konkret aussieht, zeigt die eigene Messung von Alexandrya.AI. Der Brand-Perception-Snapshot vom 20. Oktober 2026 wertet die Antworten aus dem Zeitraum 20. September bis 20. Oktober 2026 aus, im eigenen Projekt mit 38 getrackten Prompts. Für Alexandrya.AI bildet er fünf Kategorien. Der Einstiegspreis von 79 Euro pro Monat erscheint in 2 von 4 Antworten, die Alexandrya.AI nennen, und ist korrekt. Das Task-Board taucht in 1 von 4 Antworten auf, Perplexity schreibt dazu „Tracking plus priorisiertes Task-Board statt reiner Beobachtung“. Die aufschlussreichste Kategorie ist neutral bewertet und trotzdem ein Problem: In 4 von 4 Antworten fehlen Angaben zu Agentur-Funktionen wie Multi-Client-Verwaltung, Exporten oder Agentur-Reporting. Alexandrya.AI hat eigene Agentur-Tarife und CSV-Export, aber die Modelle wissen es nicht. In Vergleichsantworten für Agenturen gewinnt dadurch der Wettbewerber, der seine Agenturpakete öffentlich beschreibt. Eine Lücke dieser Art findet kein Sentiment-Score, weil kein negatives Wort fällt.
Widersprüche zeigen sich auch bei Wettbewerbern im selben Snapshot. Für einen Anbieter nannten die meisten Antworten einen Einstiegspreis von 29 US-Dollar pro Monat, ein deutschsprachiger Vergleich dagegen 200 bis 600 Euro. Wer solche Abweichungen über die eigene Marke findet, hat in der Regel eine alte oder fehlerhafte Drittquelle, die von einem Teil der Modelle gezogen wird.
Für die eigene Prüfung reichen vier Fragen je Antwort: Wird die Marke genannt? Stimmt jeder genannte Fakt mit dem eigenen Stammblatt überein? Welche Eigenschaft fehlt, die für diesen Prompt wichtig wäre? Auf welche Quelle stützt sich die Aussage?
Welche Schritte folgen, wenn eine KI falsche Fakten über die Marke nennt?
Nennt eine KI falsche Fakten über deine Marke, prüfst du zuerst die Entity-Konsistenz: Stimmen Gründungsjahr, Firmensitz, Produktbeschreibung und Preise auf deiner Website mit Wikipedia, Wikidata, Branchenverzeichnissen und Bewertungsportalen überein? In unserer Projektarbeit ist ein Widerspruch zwischen diesen Quellen die Ursache, die wir am häufigsten finden. Meist übernimmt das Modell den Fehler aus einer Quelle, die etwas anderes sagt als du.
Der Ablauf hat fünf Schritte, und die Reihenfolge zählt. Wer direkt mit Schritt vier anfängt, korrigiert womöglich die falsche Quelle.
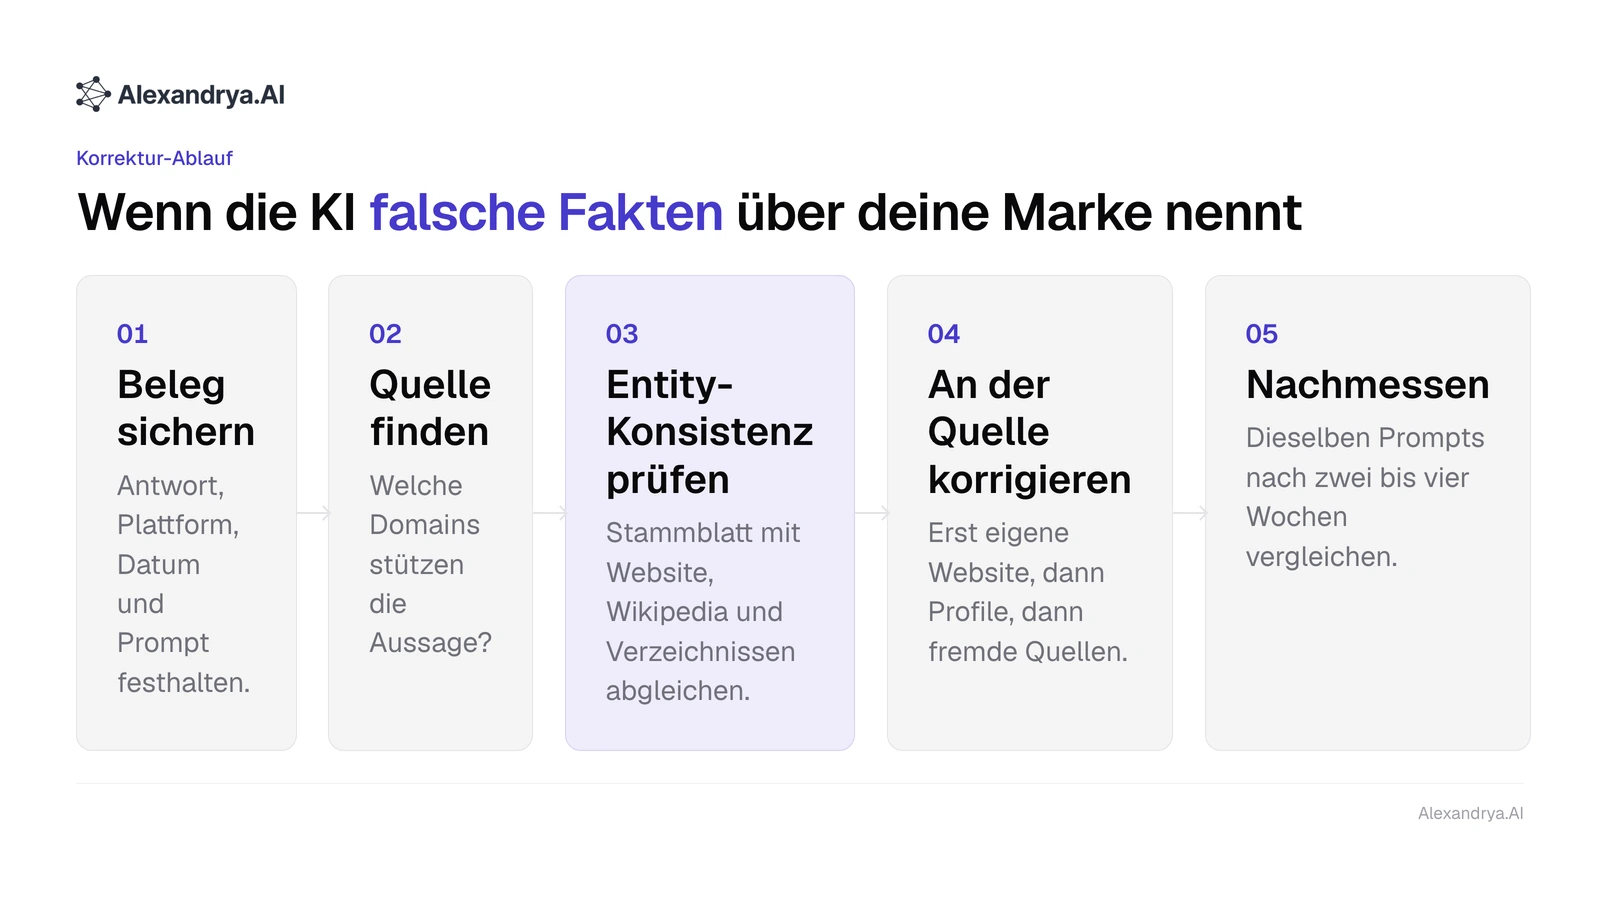
Korrektur-Ablauf bei falschen Fakten in KI-Antworten. Eigene Einordnung von Alexandrya.AI, Stand Oktober 2026.
- Beleg sichern. Antwort im Wortlaut, Plattform, Datum und Prompt festhalten. Ohne Beleg lässt sich später nicht zeigen, ob die Korrektur gewirkt hat.
- Quelle finden. Bei Perplexity und in der ChatGPT-Suche stehen die Quellen unter der Antwort. Fehlt die Quellenangabe, hilft die Quellenanalyse über viele Antworten: Welche Domains tauchen zu diesem Prompt immer wieder auf?
- Entity-Konsistenz prüfen. Lege ein Fakten-Stammblatt an mit Firmenname in exakter Schreibweise, Sitz, Gründungsjahr, Geschäftsführung, Produktkategorie, Preisen mit Stand und den drei wichtigsten Funktionen. Gleiche es mit jeder Quelle ab, die in Schritt 2 auftauchte.
- An der Quelle korrigieren. Zuerst die eigene Website, weil du sie sofort ändern kannst: Über-uns-Seite, Preisseite, Organization-Schema. Dann die Profile, die du selbst verwaltest, etwa Google-Unternehmensprofil, LinkedIn und Einträge in Verzeichnissen. Bei fremden Quellen schreibst du die Redaktion an und lieferst den richtigen Wert mit Beleg.
- Nachmessen. Dieselben Prompts laufen weiter, und nach zwei bis vier Wochen vergleichst du mit dem Beleg aus Schritt 1. Nach unserer Erfahrung reagieren Plattformen mit Live-Suche wie Perplexity schneller als Antworten, die stärker auf Trainingsdaten beruhen.
Zwei Quellen haben eigene Regeln. Bei Wikipedia rät die Richtlinie zu Interessenkonflikten (abgerufen am 22. Oktober 2026) davon ab, Artikel über das eigene Unternehmen selbst zu bearbeiten. Änderungen schlägst du auf der Diskussionsseite des Artikels vor, und wer dafür bezahlt wird, muss Arbeitgeber und Auftraggeber offenlegen. Beim Google Knowledge Panel kannst du laut Google-Hilfe zur Infobox (abgerufen am 22. Oktober 2026) Anspruch auf das Panel erheben, die Identität über ein offizielles Profil wie Search Console oder YouTube bestätigen und danach Änderungen mit Belegen über die Feedback-Funktion vorschlagen.
Eine direkte Korrekturfunktion für Marken bieten ChatGPT, Perplexity und Gemini nicht. Die Daumen-runter-Bewertung unter einer Antwort ist Nutzerfeedback, eine kurzfristige Wirkung auf die Antworten für andere Nutzer ist nicht erkennbar. Wirksam ist nur der Weg über die Quellen.
Welche Maßnahmen helfen bei negativen Bewertungen der Marke auf KI-Plattformen?
Bei negativen Bewertungen der Marke auf KI-Plattformen hilft zuerst die Unterscheidung, ob die Kritik berechtigt ist. Fasst ChatGPT oder Perplexity echte Kundenstimmen von Bewertungsportalen zusammen, ändert sich die Antwort erst, wenn sich die Bewertungen ändern: durch Antworten auf Rezensionen, gelöste Probleme und neue Bewertungen zufriedener Kunden. Beruht die negative Einordnung auf einem veralteten Vergleichsartikel, greift der Korrektur-Ablauf an der Quelle.
Gekaufte oder selbst geschriebene Bewertungen schaden mehr, als sie nützen. Bewertungsportale löschen sie, und eine Marke, die beim Fälschen auffällt, liefert den Modellen die nächste negative Quelle gleich mit. Wirksamer ist es, Kunden nach einem gelösten Fall aktiv um eine Bewertung zu bitten und auf Kritik öffentlich und konkret zu antworten, denn auch diese Antworten werden gecrawlt.
Wer ist im Unternehmen für Markenmonitoring in KI-Antworten zuständig?
Markenmonitoring in KI-Antworten braucht eine verantwortliche Person und drei beteiligte Rollen, weil die Ursachen in unterschiedlichen Abteilungen liegen. Die Messung selbst sitzt meist im SEO- oder Content-Team, das auch die Prompts pflegt. Korrekturen an Drittquellen und Bewertungsportalen gehören zur PR, die Freigabe der richtigen Fakten zum Produktmarketing.
| Rolle | Verantwortet | Typische Aufgabe aus dem Monitoring |
|---|---|---|
| SEO und Content | Prompts, Messung, eigene Website, strukturierte Daten | Preisseite und Organization-Schema angleichen, Seite für fehlende Funktion schreiben |
| PR und Kommunikation | Presse, Wikipedia-Diskussion, Bewertungsportale, Verzeichnisse | Redaktion eines Vergleichsartikels um Korrektur bitten, auf Rezensionen antworten |
| Produktmarketing | Fakten-Stammblatt, Preise, Positionierung | Stammblatt nach jeder Preis- oder Funktionsänderung aktualisieren |
| Rechtsabteilung | nur Markenrecht | bei Markenverletzung oder Verwechslung mit fremder Marke prüfen |
Ohne feste Zuständigkeit bleibt der Befund im Dashboard liegen. Ein Befund wird erst dann zur Korrektur, wenn er als Aufgabe mit Namen und Status bei einer dieser Rollen landet.
Worauf achtest du, wenn du KI-Markenmonitoring-Software kaufen willst?
Wer KI-Markenmonitoring-Software kaufen will, sollte sie an fünf Fragen messen: Welche KI-Plattformen werden abgefragt? Wird Sentiment je Thema mit Belegzitat ausgewiesen statt als Gesamtwert? Zeigt das Werkzeug die Quellen hinter einer Aussage? Wie oft wird gemessen? Wird aus einem Befund eine Aufgabe mit Verantwortlichem? Ein Werkzeug, das nur Nennungen zählt, beantwortet die Frage nach der Richtigkeit nicht.
| Kaufkriterium | Warum es zählt | Alexandrya.AI, Stand Oktober 2026 |
|---|---|---|
| Plattformabdeckung | Antworten unterscheiden sich je Plattform | ChatGPT, Gemini, Google AI Mode, Google AI Overviews, Perplexity, Microsoft Copilot, Claude, Meta AI, Grok; je Tarif 3 oder 5 wählbar |
| Sentiment je Thema mit Beleg | ein Gesamtwert verdeckt Lücken | Brand Perception mit Kategorien, Sentiment, Strengths, Gaps und Belegzitaten |
| Quellen hinter der Aussage | Korrektur setzt an der Quelle an | Quellen und Domains mit Zitat-Mix nach Quellentyp und Position in der Quellenliste |
| Messfrequenz | Antworten schwanken von Tag zu Tag | tägliches Tracking in allen Tarifen, Perception-Snapshots im Zeitverlauf |
| Vom Befund zur Aufgabe | sonst bleibt der Befund liegen | Action Plan mit Content Briefs, Outreach Targets und Quick Wins, Tasks mit Open, In Progress, Done |
| Preis | Budget für den Einstieg | 79, 199 oder 399 Euro pro Monat für 50, 150 oder 350 Prompts, Enterprise individuell |
Alexandrya.AI ist ein Werkzeug für KI-Sichtbarkeit aus München, das Nennungen in ChatGPT, Gemini, Perplexity und Bing Copilot misst und daraus Content- und Citation-Aufgaben ableitet. Eine Grenze gehört zur ehrlichen Kaufentscheidung: Alexandrya.AI hat derzeit keine Alerts und keine Slack-Anbindung. Eine neue Fehldarstellung siehst du im Dashboard und im monatlichen E-Mail-Report, nicht als Sofortmeldung. Wer eine Krisenkommunikation mit Minuten-Reaktion aufbauen will, braucht dafür zusätzlich ein Social-Listening-Werkzeug. Die Funktionen im Einzelnen stehen auf der Produktseite, die Tarife auf der Preisseite. Alle Tarife lassen sich sieben Tage ohne Kreditkarte testen.
Vor dem Kauf lohnt ein Test mit den eigenen zehn wichtigsten Prompts. Die Frage dabei ist schlicht, ob das Werkzeug innerhalb einer Woche mindestens eine falsche oder fehlende Aussage über deine Marke findet und dir sagt, welche Quelle dahintersteckt. Die Grundbegriffe rund um Nennung, Zitat und Share of Voice erklärt der Artikel Was ist KI-Sichtbarkeit.
Häufige Fragen
Wie oft sollte Markenmonitoring in KI-Antworten laufen?
Die Abfrage selbst sollte täglich laufen, weil KI-Antworten von Tag zu Tag schwanken und eine Einzelmessung wenig aussagt. Die Auswertung braucht einen anderen Takt: Sentiment und Fakten einmal pro Woche prüfen, Snapshots einmal im Monat vergleichen. Alexandrya.AI fragt in allen Tarifen täglich ab. Nach Preisänderungen, Produktstarts oder kritischer Presse lohnt eine zusätzliche Prüfung der wichtigsten Prompts innerhalb weniger Tage.
Mit welchen Kosten rechnest du bei KI-Markenmonitoring-Software?
Bei Alexandrya.AI kostet Markenmonitoring in KI-Antworten 79 Euro pro Monat für 50 Prompts und drei Modelle, 199 Euro für 150 Prompts und fünf Modelle und 399 Euro für 350 Prompts, Stand Oktober 2026. Enterprise ist individuell. Bei jährlicher Zahlung gibt es 15 Prozent Rabatt, und der Test läuft sieben Tage ohne Kreditkarte.
Kann ich falsche Aussagen in ChatGPT direkt korrigieren lassen?
Nein, ChatGPT, Perplexity und Gemini bieten Marken keine Funktion, um Aussagen direkt zu korrigieren. Die Bewertung per Daumen unter einer Antwort ist Nutzerfeedback ohne verlässliche Wirkung auf andere Nutzer. Wirksam ist die Korrektur an den Quellen, aus denen die Modelle schöpfen: eigene Website, Verzeichnisse, Wikipedia über die Diskussionsseite, Bewertungsportale und Vergleichsartikel.
Worin unterscheiden sich Markenmonitoring und Markenüberwachung?
Markenüberwachung ist ein Begriff aus dem Markenrecht und prüft Register und Marktplätze auf neue Marken, die mit der eigenen kollidieren. Markenmonitoring meint im Marketing die Beobachtung, wie über eine Marke gesprochen wird. Markenmonitoring in KI-Antworten prüft zusätzlich, ob KI-Assistenten wie ChatGPT oder Gemini die Marke richtig darstellen und auf welche Quellen sie sich stützen.
Was bedeutet Sentiment in KI-Antworten?
Sentiment in KI-Antworten beschreibt, ob ein KI-Assistent eine Marke positiv, neutral oder negativ einordnet. Aussagekräftig wird der Wert erst je Thema, etwa Preis, Funktionsumfang oder Support, und mit dem Zitat aus der Antwort als Beleg. Ein neutraler Wert kann trotzdem ein Problem sein, wenn wichtige Eigenschaften der Marke in den Antworten gar nicht vorkommen.
Kann ich Markenmonitoring in KI-Antworten auch manuell machen?
Für einen ersten Eindruck reicht es, zehn Prompts von Hand in ChatGPT, Perplexity und Gemini zu stellen und die Antworten in einer Tabelle zu sammeln. Für eine belastbare Aussage reicht es nicht, weil die Antworten schwanken und täglich neu entstehen. Wer drei Plattformen und 30 Prompts täglich von Hand prüft, sammelt rund 90 Antworten am Tag, die jemand lesen und bewerten muss.
Kostenloses GEO-Audit
Finde heraus, was ChatGPT, Perplexity und Gemini heute über deine Marke sagen und welche Aussage davon nicht stimmt. Alexandrya.AI zeigt dir Sentiment je Thema, die Belegzitate und die Quellen dahinter, sieben Tage kostenlos und ohne Kreditkarte. Markenbild in KI-Antworten kostenlos prüfen
Häufig gestellte Fragen
Wie oft sollte Markenmonitoring in KI-Antworten laufen?
Die Abfrage selbst sollte täglich laufen, weil KI-Antworten von Tag zu Tag schwanken und eine Einzelmessung wenig aussagt. Die Auswertung braucht einen anderen Takt: Sentiment und Fakten einmal pro Woche prüfen, Snapshots einmal im Monat vergleichen. Alexandrya.AI fragt in allen Tarifen täglich ab. Nach Preisänderungen, Produktstarts oder kritischer Presse lohnt eine zusätzliche Prüfung der wichtigsten Prompts innerhalb weniger Tage.
Mit welchen Kosten rechnest du bei KI-Markenmonitoring-Software?
Bei Alexandrya.AI kostet Markenmonitoring in KI-Antworten 79 Euro pro Monat für 50 Prompts und drei Modelle, 199 Euro für 150 Prompts und fünf Modelle und 399 Euro für 350 Prompts, Stand Oktober 2026. Enterprise ist individuell. Bei jährlicher Zahlung gibt es 15 Prozent Rabatt, und der Test läuft sieben Tage ohne Kreditkarte.
Kann ich falsche Aussagen in ChatGPT direkt korrigieren lassen?
Nein, ChatGPT, Perplexity und Gemini bieten Marken keine Funktion, um Aussagen direkt zu korrigieren. Die Bewertung per Daumen unter einer Antwort ist Nutzerfeedback ohne verlässliche Wirkung auf andere Nutzer. Wirksam ist die Korrektur an den Quellen, aus denen die Modelle schöpfen: eigene Website, Verzeichnisse, Wikipedia über die Diskussionsseite, Bewertungsportale und Vergleichsartikel.
Worin unterscheiden sich Markenmonitoring und Markenüberwachung?
Markenüberwachung ist ein Begriff aus dem Markenrecht und prüft Register und Marktplätze auf neue Marken, die mit der eigenen kollidieren. Markenmonitoring meint im Marketing die Beobachtung, wie über eine Marke gesprochen wird. Markenmonitoring in KI-Antworten prüft zusätzlich, ob KI-Assistenten wie ChatGPT oder Gemini die Marke richtig darstellen und auf welche Quellen sie sich stützen.
Was bedeutet Sentiment in KI-Antworten?
Sentiment in KI-Antworten beschreibt, ob ein KI-Assistent eine Marke positiv, neutral oder negativ einordnet. Aussagekräftig wird der Wert erst je Thema, etwa Preis, Funktionsumfang oder Support, und mit dem Zitat aus der Antwort als Beleg. Ein neutraler Wert kann trotzdem ein Problem sein, wenn wichtige Eigenschaften der Marke in den Antworten gar nicht vorkommen.
Kann ich Markenmonitoring in KI-Antworten auch manuell machen?
Für einen ersten Eindruck reicht es, zehn Prompts von Hand in ChatGPT, Perplexity und Gemini zu stellen und die Antworten in einer Tabelle zu sammeln. Für eine belastbare Aussage reicht es nicht, weil die Antworten schwanken und täglich neu entstehen. Wer drei Plattformen und 30 Prompts täglich von Hand prüft, sammelt rund 90 Antworten am Tag, die jemand lesen und bewerten muss.
Wie sichtbar ist deine Marke in der KI?
Teste Alexandrya.AI 7 Tage kostenlos und sieh, wie ChatGPT, Gemini, Perplexity, AI Overviews und Copilot über deine Marke sprechen.
- 7 Tage kostenlos
- Keine Kreditkarte nötig
- Voller Funktionsumfang
- Jederzeit kündbar
Über den Autor
Talaal Max Habib
Geschäftsführer Alexandrya.AI
Talaal Max Habib berät seit 2015 Unternehmen aus Industrie, Mittelstand und E-Commerce zu SEO und Generative Engine Optimization. Mit seinem Team hat er Alexandrya.AI entwickelt, die Plattform aus München, die misst, wie Marken in ChatGPT, Perplexity und Gemini erscheinen.
LinkedIn