Wie du das Sentiment deiner Marke in ChatGPT-Antworten misst
ChatGPT Sentiment-Analyse für Marken heißt: jede Aussage über die Marke je Aspekt bewerten, mit Zitat belegen und je Plattform genug Antworten sammeln.
Geschäftsführer Alexandrya.AI
Die ChatGPT Sentiment-Analyse für Marken misst, ob ChatGPT, Perplexity, Gemini und andere KI-Assistenten deine Marke positiv, neutral oder negativ darstellen. Belastbar wird sie, wenn du jede Aussage über die Marke einzeln bewertest, einem Aspekt wie Preis, Qualität oder Service zuordnest, mit dem Zitat aus der Antwort belegst und je Plattform genug Antworten sammelst, damit eine einzelne nicht das Ergebnis kippt.
Die Zahlen aus dem eigenen Projekt sind eine eigene Messung von Alexandrya.AI, Stand 27. Oktober 2026, 43 getrackte Prompts, ergänzt um drei Brand-Perception-Snapshots vom Oktober 2026. Alexandrya.AI ist unser eigenes Produkt. Wie du falsche Fakten korrigierst, steht im Artikel Markenmonitoring in KI-Antworten. Hier geht es allein um die Messung.
Was Sentiment-Analyse für Marken in KI-Antworten erfasst
Sentiment-Analyse in KI-Antworten erfasst, ob ChatGPT, Perplexity, Gemini oder Google AI Overviews eine Marke in generierten Texten positiv, neutral oder negativ darstellen. Review-Monitoring zählt dagegen Sterne und Kommentare, die Kunden auf Bewertungsplattformen selbst geschrieben haben. Die KI-Antwort ist eine Zusammenfassung vieler Quellen, die bei jeder Anfrage neu entsteht. Eine Marke mit guten Bewertungen kann deshalb in KI-Antworten negativ erscheinen, wenn das Modell einen alten Testbericht oder einen kritischen Forumsbeitrag heranzieht.
| Merkmal | Review-Monitoring | Sentiment-Analyse in KI-Antworten |
|---|---|---|
| Gegenstand | Bewertungen auf Plattformen wie Google, Trustpilot oder G2 | Antworten von ChatGPT, Perplexity, Gemini, Google AI Overviews oder Copilot |
| Wie die Daten entstehen | Kunden schreiben, Bewertungen werden gezählt | feste Prompts werden regelmäßig abgefragt |
| Einheit der Auswertung | eine Bewertung mit Sternen | eine Aussage über die Marke in einer Antwort |
| Stabilität | eine Bewertung bleibt stehen | dieselbe Frage liefert bei jedem Abruf eine andere Antwort |
| Hebel bei negativem Ergebnis | auf die Bewertung antworten, Problem lösen | Quelle hinter der Aussage finden und prüfen |
Der Unterschied steckt in der vorletzten Zeile. Weil eine KI-Antwort bei jeder Anfrage neu entsteht, braucht ihre Sentiment-Messung Wiederholung und eine ausreichend große Stichprobe. Als Kennzahl steht der Sentiment Score neben AI Citation Rate, Share of AI Voice und Model Coverage unter den vier GEO-Kennzahlen.
ChatGPT Sentiment-Analyse für Marken nutzen: zwei verschiedene Wege
ChatGPT lässt sich auf zwei Arten für die Sentiment-Analyse einer Marke nutzen. Als Werkzeug klassifiziert ChatGPT eigene Texte wie Kundenbewertungen, Support-Tickets oder Social-Media-Kommentare nach positiv, neutral und negativ und zeigt damit die Stimmung der Kunden. Als Gegenstand der Messung wird ChatGPT selbst abgefragt, und du wertest aus, wie das Modell deine Marke beschreibt. Für das erste reicht ChatGPT mit einer festen Anleitung, das zweite braucht wiederholte Abfragen auf mehreren Plattformen.
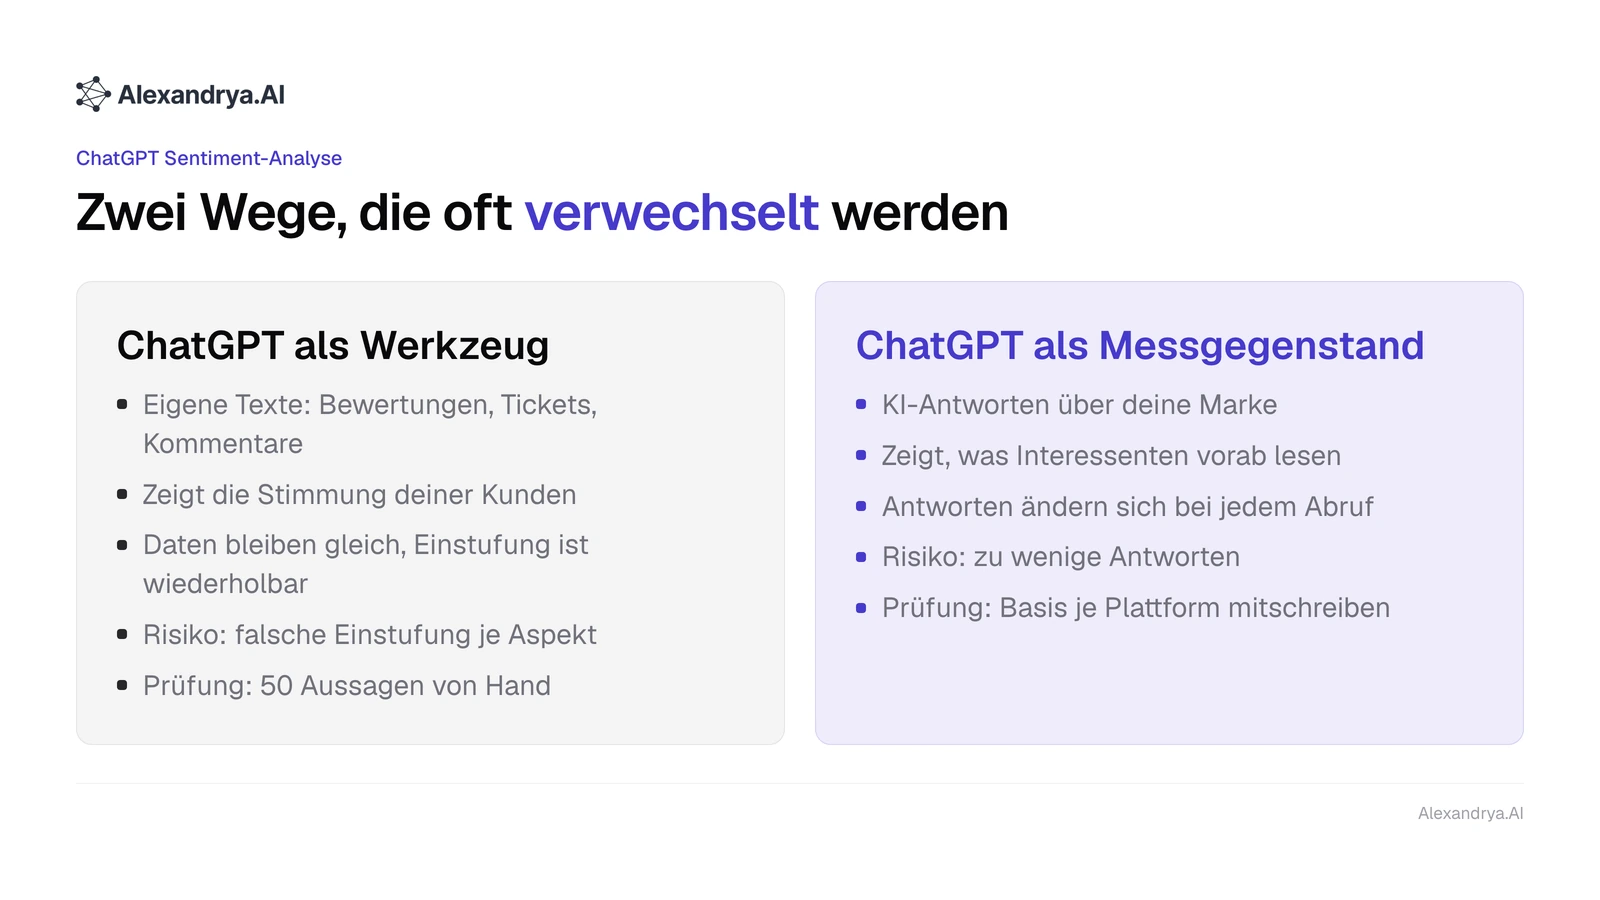
Zwei Bedeutungen von ChatGPT-Sentiment-Analyse mit unterschiedlichen Daten und Risiken. Eigene Einordnung von Alexandrya.AI, Stand Oktober 2026.
Wie leicht die beiden Bedeutungen durcheinandergeraten, zeigt eine Antwort von Microsoft Copilot vom 27. Oktober 2026 auf den Prompt „chatgpt sentiment analyse für marken nutzen“, den Alexandrya.AI täglich trackt. An erster Stelle der Quellenliste steht ein Leitfaden, wie Sprachmodelle Social-Media-Texte und Bewertungen klassifizieren, an zweiter ein Leitfaden zum Monitoring von ChatGPT-Antworten. Copilot verschmilzt beides zu einer Antwort.
Für ChatGPT als Werkzeug gibt es Messwerte. Eine Forschergruppe um Zengzhi Wang hat ChatGPT auf 17 Datensätzen mit trainierten Modellen verglichen (arXiv, Fassung vom 17. Februar 2024, abgerufen am 27. Oktober 2026). Filmkritiken stufte ChatGPT ohne Training zu 93,12 Prozent richtig als positiv oder negativ ein, ein trainiertes BERT-Modell zu 95,47 Prozent. Beim Herauslösen von Aspekten samt Stimmung aus Restaurantbewertungen lag ChatGPT mit einem F1-Wert von 69,14 deutlich hinter BERT mit 77,75. Die Werte gelten für das Modell von 2023, die Lücke bei Aspekten spricht für eine Handprüfung.
Wer eigene Texte von ChatGPT einstufen lässt, braucht eine feste Anleitung. Ein eigenes Beispiel für Bewertungen eines Herstellers von Kaffeevollautomaten:
| Baustein der Anleitung | Wortlaut im Beispiel | verhindert |
|---|---|---|
| Aufgabe | „Zerlege jede Bewertung in einzelne Aussagen.“ | ein Gesamturteil für einen gemischten Text |
| Aspekte | „Ordne jede Aussage genau einem Aspekt zu: Preis, Qualität, Service, Bedienung, Lieferung.“ | Aspekte, die von Lauf zu Lauf wechseln |
| Skala | „Vergib positiv, neutral oder negativ. Neutral heißt: Tatsache ohne Wertung.“ | eine unklare Grenze zwischen neutral und negativ |
| Beleg | „Gib zu jeder Aussage den wörtlichen Textausschnitt an.“ | Einstufungen, die niemand nachprüfen kann |
| Unsicherheit | „Ist die Einstufung unklar, schreibe unklar.“ | geratene Werte |
| Ausgabe | „Antworte als Tabelle: Aussage, Aspekt, Polarität, Zitat.“ | Fließtext, der sich nicht auszählen lässt |
Vor dem ersten Einsatz bewerten zwei Personen 50 Aussagen von Hand, und du vergleichst ihr Ergebnis mit dem von ChatGPT. Weicht ein Aspekt auffällig ab, schärfst du dessen Definition und wiederholst den Test. Namen, E-Mail-Adressen und Bestellnummern entfernst du vor dem Hochladen.
So läuft eine Sentimentanalyse von Marken in ChatGPT ab
Eine Sentimentanalyse von Marken in ChatGPT läuft in fünf Schritten: ein festes Prompt-Set anlegen, die Antworten je Plattform wiederholt sammeln, jede Antwort in einzelne Aussagen über die Marke zerlegen, jede Aussage einem Aspekt und einer Polarität mit Belegzitat zuordnen und die Ergebnisse als datierte Snapshots vergleichen. Ausgewertet wird die einzelne Aussage, weil dieselbe Antwort den Preis loben und den Kundendienst kritisieren kann.
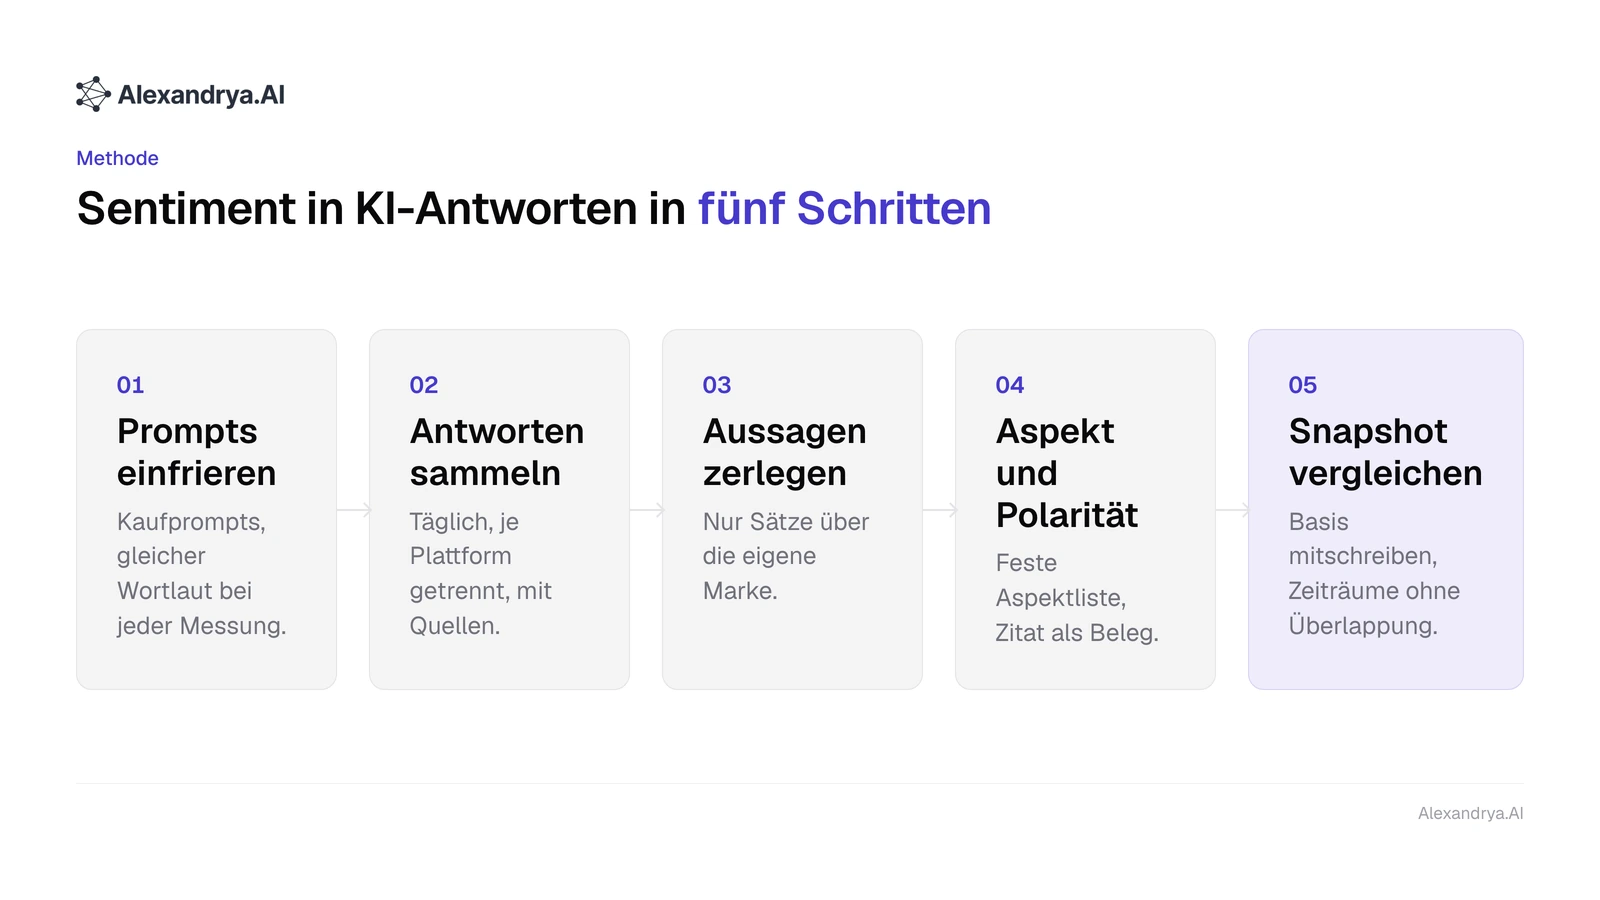
Fünf Schritte der Sentiment-Messung in KI-Antworten. Eigene Einordnung von Alexandrya.AI, Stand Oktober 2026.
- Prompt-Set festlegen und einfrieren. Nimm die Fragen, die Käufer vor einer Entscheidung stellen, etwa „Welcher Kaffeevollautomat bis 800 Euro ist empfehlenswert?“. Der Wortlaut bleibt über alle Messungen gleich, Prompts nach Nachteilen bilden eine eigene Gruppe.
- Antworten je Plattform wiederholt sammeln. Jeder Prompt läuft täglich auf ChatGPT, Perplexity, Gemini, Google AI Overviews oder Copilot. Gespeichert werden Antwort, Datum, Plattform und angezeigte Quellen.
- Aussagen über die Marke herauslösen. Ausgewertet werden nur Sätze über deine Marke. Ein Vergleichssatz wie „günstiger als Marke B“ zählt für beide Marken, einmal positiv und einmal negativ.
- Aspekt, Polarität und Beleg vergeben. Jede Aussage bekommt einen Aspekt aus einer festen Liste, eine Polarität und das wörtliche Zitat. Ein Aspekt, der in der Antwort fehlt, wird als „nicht erwähnt“ notiert, nicht als neutral.
- Verdichten und als Snapshot speichern. Je Plattform und Aspekt zählst du positive, neutrale und negative Aussagen, schreibst die Basis dazu und speicherst das Ergebnis mit Zeitraum.
Der vierte Schritt trennt zwei Befunde, die in einem Gesamtwert zusammenfallen würden. Eine neutrale Aussage nennt eine Eigenschaft ohne Wertung, ein fehlender Aspekt heißt, dass die KI dazu nichts sagt. Im Snapshot vom 27. Oktober 2026 fasst die neutrale Kategorie „Vergleichslisten-Präsenz“ 2 von 11 Antworten zusammen, die Alexandrya.AI in Alternativenlisten aufführen, ohne Funktionen zu vergleichen. Fehlende Angaben stehen dort als Gaps, auch in positiven Kategorien: Unter „Mehrplattform-Monitoring“ steht, dass die Antworten nicht erläutern, welche Plattformen in welchem Tarif enthalten sind.
Beispiel einer Produktbewertung in einer KI-Antwort, Aussage für Aussage
Für dieses Beispiel ist die KI-Antwort konstruiert: Marke A und Marke B sind keine echten Marken, und der Text stammt aus keiner Messung. Angenommen, ein KI-Assistent antwortet auf den Prompt „Welcher Kaffeevollautomat bis 800 Euro ist empfehlenswert?“ mit diesem Absatz: „Marke A gilt in mehreren Tests als langlebig und liefert gleichmäßigen Milchschaum. Mit rund 750 Euro liegt das Modell am oberen Ende der Preisspanne. Einige Nutzer berichten von langen Wartezeiten beim Kundendienst. Wer vor allem Wert auf einfache Reinigung legt, ist mit Marke B besser bedient.“
| Aussage über Marke A | Aspekt | Polarität | Belegzitat | Quelle hinter der Aussage (im Beispiel) |
|---|---|---|---|---|
| ist langlebig | Qualität | positiv | „gilt in mehreren Tests als langlebig“ | zwei Testberichte von 2026 |
| liefert gleichmäßigen Milchschaum | Qualität | positiv | „liefert gleichmäßigen Milchschaum“ | ein Testbericht von 2026 |
| kostet rund 750 Euro | Preis | neutral | „liegt am oberen Ende der Preisspanne“ | Händlerseite |
| lange Wartezeiten beim Kundendienst | Service | negativ | „Einige Nutzer berichten von langen Wartezeiten“ | ein Forumsbeitrag von 2023 |
| Reinigung bei Marke B einfacher | Bedienung | negativ, indirekt | „ist mit Marke B besser bedient“ | ein Vergleichsartikel |
Auf Antwortebene bekäme dieser Text das Etikett „gemischt“, mit dem niemand arbeiten kann. Je Aspekt ist das Bild eindeutig: Qualität zweimal positiv, Preis neutral, Service und Bedienung je einmal negativ. Ob „am oberen Ende der Preisspanne“ neutral oder negativ zählt, legt die Anleitung fest, für alle Antworten gleich.
Negatives Sentiment in einer KI-Antwort lässt sich erst bewerten, wenn die Quelle hinter der Aussage bekannt ist. Stützt sich die Kritik auf einen veralteten Testbericht, einen einzelnen Forumsbeitrag oder einen Vergleich mit überholten Preisen, liegt das Problem bei der Quelle und nicht beim Produkt. Perplexity und die Suche in ChatGPT zeigen ihre Quellen zur Antwort an. Bei Antworten ohne Quellenangabe hilft nur der Abgleich über viele Abrufe.
Im Beispiel hängt die Service-Kritik an einem Forumsbeitrag von 2023. Hat sich der Kundendienst seitdem verbessert, fehlt eine aktuelle Quelle, die das belegt. Stimmt die Kritik weiterhin, liegt die Aufgabe beim Service.
Wie wenig eine negative Wertung tragen kann, zeigt auch die eigene Messung. Im Snapshot vom 27. Oktober 2026 steht für einen der beobachteten Wettbewerber eine negative Kategorie zum Preisniveau. Preise kommen in 6 von 15 Antworten über diese Marke vor, die genannten Einstiegspreise widersprechen sich, und die Wertung „besonders teuer“ stammt aus einer einzigen Copilot-Antwort. Den Anbieter nennen wir nicht, weil es um die Methode geht.
Drei Snapshots aus der eigenen Messung von Alexandrya.AI
Die eigene Messung von Alexandrya.AI zeigt, wie klein die Basis für eine Sentiment-Aussage über eine einzelne Marke ist. Von 43 täglich getrackten Prompts nennen die KI-Antworten Alexandrya.AI im Antworttext bei 10, Stand 27. Oktober 2026. Die wöchentlichen Brand-Perception-Snapshots stützen sich deshalb auf 4 bis 11 Antworten mit Nennung. Sentiment lässt sich nur dort messen, wo eine Marke überhaupt vorkommt.
| Snapshot vom | Zeitraum | Antworten mit Nennung | Kategorien positiv | Kategorien neutral | Kategorien negativ | Gewicht einer Antwort |
|---|---|---|---|---|---|---|
| 13.10.2026 | 13.09. bis 13.10.2026 | 7 | 4 | 1 | 0 | 14,3 Prozentpunkte |
| 20.10.2026 | 20.09. bis 20.10.2026 | 4 | 4 | 1 | 0 | 25,0 Prozentpunkte |
| 27.10.2026 | 27.09. bis 27.10.2026 | 11 | 3 | 2 | 0 | 9,1 Prozentpunkte |
Quelle: eigene Messung von Alexandrya.AI, Brand-Perception-Snapshots für alexandrya.ai, abgerufen am 27. Oktober 2026.
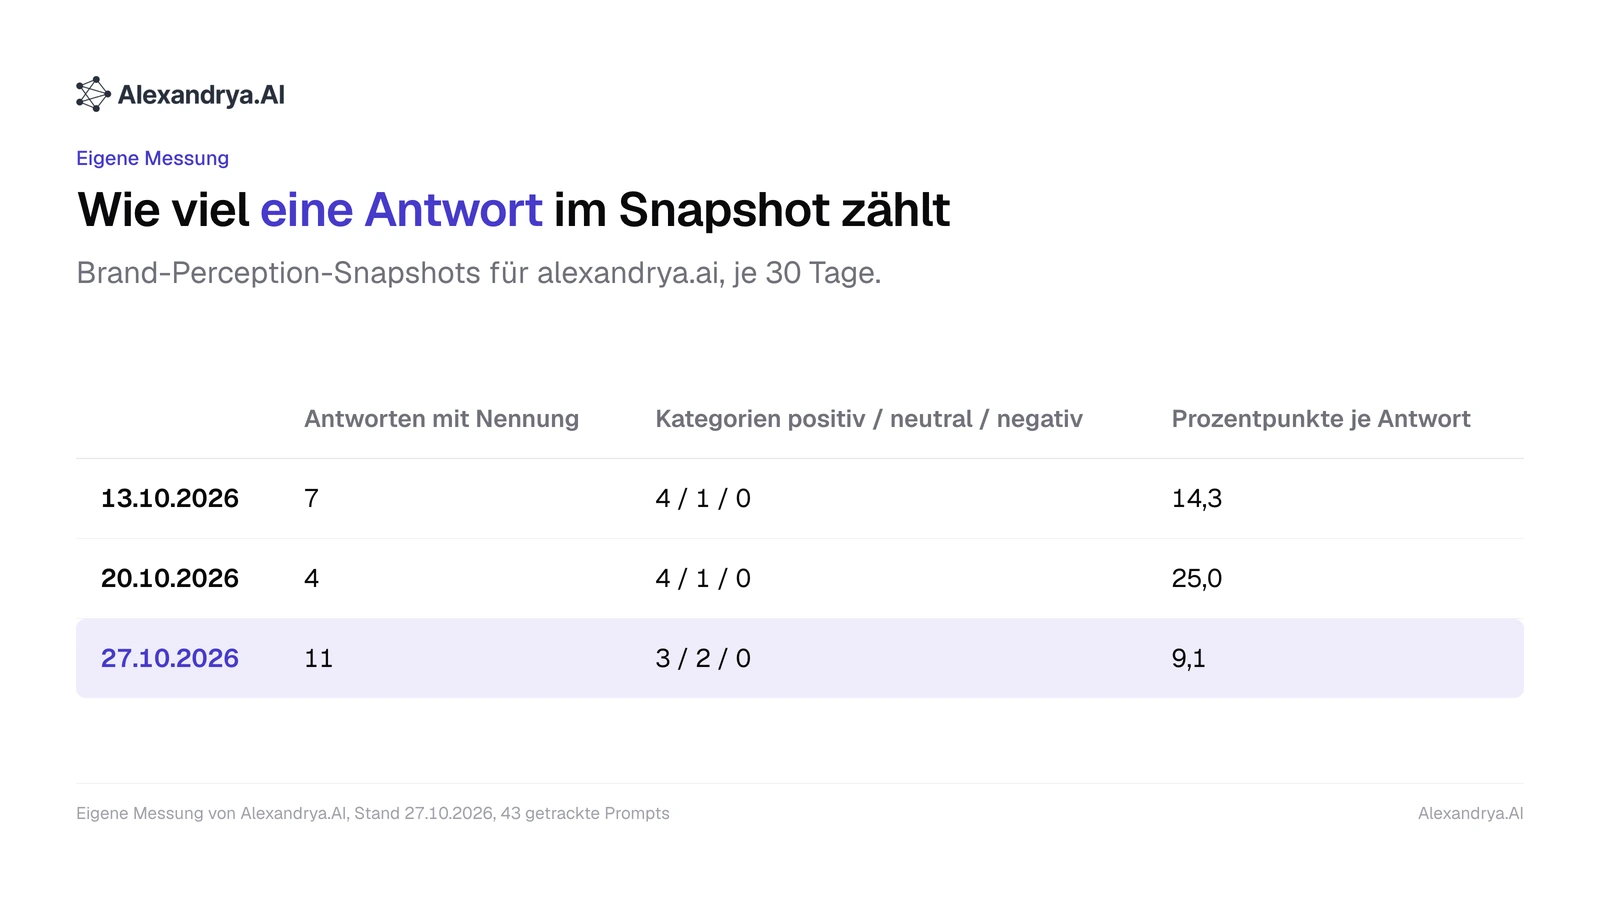
Drei Wochen-Snapshots mit 4 bis 11 Antworten: Eine einzelne Antwort zählt zwischen 9,1 und 25 Prozentpunkten. Eigene Messung von Alexandrya.AI, Stand 27. Oktober 2026.
Die Kategorien wechseln von Snapshot zu Snapshot. Keiner der fünf Kategorienamen vom 20. Oktober taucht am 27. Oktober wieder auf. Aus „Einstiegspreis“ wird ein Teil von „Agenturpaket & Preis“, und diese Kategorie beschreibt trotz ihres Namens den Einstiegspreis von 79 Euro und das Task-Board, keine Agenturfunktionen. Für einen Verlauf über Monate ordnest du die Kategorien festen Aspekten zu und liest Beschreibung und Belegzitate statt nur das Etikett.
Jeder Snapshot im eigenen Projekt umfasst 30 Tage und entsteht wöchentlich, zwei aufeinanderfolgende teilen sich also gut drei Wochen Daten. Das ChatGPT-Zitat „Alexandrya.AI startet bei 79 €/Monat und bietet tägliches Tracking“ steht in allen drei Snapshots. Wer den 20. mit dem 27. Oktober vergleicht, vergleicht zum großen Teil dieselben Antworten.
Keiner der drei Snapshots enthält eine negative Kategorie für Alexandrya.AI, frei von Schwächen ist das Bild trotzdem nicht. In der positiven Kategorie „Plattform-Quellenanalyse“ mit 5 von 11 Antworten hält der Snapshot vom 27. Oktober trotzdem fest, dass die Antworten keine realen Kundenergebnisse und keine unabhängig geprüften Genauigkeitswerte zeigen. Dieser Satz sagt, welcher Beleg in den Quellen fehlt, und ist damit nützlicher als das Etikett.
Antwortvarianz, Stichprobe und Prompt-Wortlaut begrenzen die Aussagekraft
KI-Antworten schwanken von Abruf zu Abruf so stark, dass eine einzelne Antwort keine Sentiment-Aussage trägt. In einer Studie von SparkToro und Gumshoe.ai mit 2.961 Antworten von ChatGPT, Claude und Google AI lieferten die Systeme bei derselben Frage in weniger als einem von 100 Fällen dieselbe Markenliste (SparkToro, 28. Januar 2026, abgerufen am 27. Oktober 2026). Messgröße ist deshalb der Anteil über viele Abrufe, nie die Einzelantwort.
Die Studie entstand mit Gumshoe.ai, einem Anbieter von Tracking-Werkzeugen, und ist nicht begutachtet. SparkToro hält den Sichtbarkeitsanteil über Dutzende bis Hunderte mehrfach abgefragter Prompts für brauchbar, eine Rangposition nicht. Für das Sentiment gilt dieselbe Logik.
Die Stichprobe bestimmt, wie stark eine einzelne Antwort zählt. Bei 4 Antworten verschiebt eine abweichende Antwort einen Anteil um 25 Prozentpunkte, bei 11 Antworten um 9,1 und bei 100 Antworten um einen Punkt. Taucht ein Aspekt in 5 von 11 Antworten auf, reicht das 95-Prozent-Konfidenzintervall nach Wilson von 21 bis 72 Prozent, bei 45 von 100 Antworten von 36 bis 55 Prozent (eigene Rechnung). Erst bei rund 30 Antworten je Aspekt und Plattform fällt eine einzelne mit 3,3 Prozentpunkten weniger ins Gewicht, darunter ist die Zählung ehrlicher als ein Prozentwert. Die Brand-Perception-Snapshots von Alexandrya.AI schreiben Häufigkeiten als Zählung, etwa „In 5 von 11 Antworten“.
Der Prompt-Wortlaut steuert das Sentiment mit. „Welche Nachteile hat Marke A?“ erzeugt Nachteile, „Welcher Kaffeevollautomat ist empfehlenswert?“ erzeugt Empfehlungen. Wer beide Gruppen mischt, misst vor allem die Zusammensetzung des Prompt-Sets. Deutsche und englische Prompts führst du getrennt, weil sie auf andere Quellen zugreifen können. Auch der Klassifizierer schwankt, deshalb halten ein festes Modell, eine feste Anleitung und eine wiederholte Stichprobe den Fehler klein.
Welche Plattform für AI-Reputation-Monitoring Sentiment nachvollziehbar ausweist
Eine Plattform für AI-Reputation-Monitoring weist Sentiment nachvollziehbar aus, wenn sie vier Dinge zeigt: die Polarität je Aspekt statt eines Gesamtwerts, das Zitat aus der Antwort als Beleg, die Trennung nach KI-Plattform und die Zahl der Antworten, auf der jeder Wert beruht. Ohne diese Basis lässt sich nicht entscheiden, ob eine Veränderung zwischen zwei Snapshots echt ist oder nur eine einzelne Antwort abbildet.
Die Anbieter lösen das unterschiedlich, Stand 27. Oktober 2026 laut ihren eigenen Seiten. Peec AI weist Sentiment als Wert von 0 bis 100 für den Ton aller Antworten mit Markennennung aus, die meisten Werte liegen laut Peec zwischen 65 und 85. Das AI Visibility Toolkit von Semrush vergleicht Markenwahrnehmung und Sentiment mit Wettbewerbern samt den Narrativen dahinter, nennt ChatGPT und Google AI Mode als abgefragte Modelle und kostet ab 99 US-Dollar im Monat. SE Visible von SE Ranking will zeigen, wann eine Marke positiv, negativ oder unzutreffend dargestellt wird, und führt ein eigenes „AI Brand Sentiment Tracking“ als „coming soon“.
Ein Gesamtwert von 0 bis 100 ist leicht zu berichten, zeigt aber nicht, welcher Aspekt ihn drückt. Eine Kategorienansicht zeigt den Aspekt, kippt bei kleiner Basis aber schneller durch eine einzelne Antwort. Frag deshalb in jeder Testphase, auf wie vielen Antworten ein Wert beruht.
Alexandrya.AI zeigt die KI-Markenwahrnehmung in der Brand Perception, für die eigene Marke und für Wettbewerber, als Kategorien mit Sentiment, Strengths, Gaps und Belegzitaten samt Plattform und speichert jede Auswertung als Snapshot mit Zeitraum. Die Funktionen stehen auf der Produktseite, die Tarife auf der Preisseite. Alexandrya.AI ist ein Werkzeug für KI-Sichtbarkeit aus München, das Nennungen in ChatGPT, Gemini, Perplexity und Bing Copilot misst und daraus Content- und Citation-Aufgaben ableitet.
Drei Grenzen gehören zur ehrlichen Einordnung. Die Kategorien werden je Snapshot neu gebildet, die Zuordnung zu festen Aspekten für einen Langzeitvergleich übernimmst du selbst. Sentiment je einzelnem Produkt oder SKU misst Alexandrya.AI nicht. Und es gibt keine Alerts und keine Slack-Anbindung, eine neue negative Kategorie siehst du im nächsten Snapshot.
Was du mit dem Ergebnis der Sentiment-Messung anfängst
Ein Sentiment-Ergebnis wird erst nützlich, wenn du für jeden negativen oder fehlenden Aspekt die Ursache bestimmst. Beruht eine negative Aussage auf einer falschen oder veralteten Quelle, ist die Quelle die Aufgabe, und die Quellenanalyse je Plattform zeigt, welche Domains hinter den Antworten stehen. Stimmt die Kritik, liegt die Aufgabe beim Produkt oder Service. Fehlt ein Aspekt, fehlt eine auffindbare Seite, die ihn beschreibt. In Alexandrya.AI werden Empfehlungen aus dem Action Plan zu Aufgaben im Task-Board mit den Status Open, In Progress und Done.
Häufige Fragen
Ab welchem Wert ist das Sentiment einer Marke in KI-Antworten gut?
Einen allgemeinen Richtwert gibt es nicht, weil die Werkzeuge unterschiedliche Skalen und Einheiten verwenden. Peec AI schreibt zu seiner Skala von 0 bis 100, dass die meisten Werte zwischen 65 und 85 liegen. Aussagekräftiger ist der Vergleich mit Wettbewerbern im selben Prompt-Set und mit deinen eigenen früheren Snapshots, jeweils je Aspekt und Plattform.
Kann ChatGPT seine eigenen Antworten über deine Marke bewerten?
ChatGPT kann gesammelte Antworten nach einer festen Anleitung klassifizieren, auch solche, die es selbst erzeugt hat. Die Frage „Wie siehst du Marke X?“ ersetzt diese Auswertung nicht, weil sie eine neue Antwort erzeugt, statt die vorhandenen zu bewerten. Trenne deshalb Abfrage und Klassifizierung und prüfe eine Stichprobe der Einstufungen von Hand.
Warum fällt das Sentiment in ChatGPT, Perplexity und Gemini unterschiedlich aus?
Die Plattformen stützen ihre Antworten auf unterschiedliche Quellen. Perplexity sucht bei jeder Anfrage live im Web, Gemini und Google AI Overviews greifen auf den Google-Index zurück, ChatGPT verbindet Trainingswissen mit einer eigenen Websuche. Ein kritischer Testbericht kann deshalb auf einer Plattform die Antwort prägen und auf einer anderen fehlen. Werte das Sentiment je Plattform getrennt aus.
Welche Aspekte gehören in eine Sentiment-Analyse für Marken?
Die Aspektliste folgt den Fragen, die Käufer vor einer Entscheidung stellen. Typisch sind Preis, Produktqualität, Service, Bedienung und Eignung für eine bestimmte Zielgruppe, bei Software kommen Integrationen und Datenschutz dazu. Lege die Liste vor der ersten Auswertung fest und ändere sie nicht zwischen zwei Snapshots, sonst lassen sich die Werte nicht vergleichen.
Woran erkennst du, dass sich das Sentiment wirklich verändert hat?
Eine echte Veränderung zeigt sich zwischen zwei Snapshots, deren Zeiträume sich nicht überschneiden und die beide genug Antworten enthalten. Überlappen die Fenster, stecken dieselben Antworten in beiden Werten. In der eigenen Messung von Alexandrya.AI taucht dasselbe ChatGPT-Zitat in drei Wochen-Snapshots hintereinander auf. Prüfe außerdem, ob sich das Prompt-Set zwischen den Messungen geändert hat.
Mit welchen Kosten rechnest du für eine automatisierte Sentiment-Messung?
Alexandrya.AI kostet 79, 199 oder 399 Euro im Monat für 50, 150 oder 350 täglich abgefragte Prompts, Enterprise wird individuell vereinbart. Die Brand Perception mit Kategorien, Sentiment, Strengths, Gaps und Belegzitaten ist Teil des Sichtbarkeits-Dashboards. Starter, Professional und Business lassen sich sieben Tage ohne Kreditkarte testen, bei jährlicher Zahlung sinkt der Preis um rund 15 Prozent.
Das Sentiment deiner Marke sieben Tage kostenlos messen
Du willst wissen, welche Aussagen ChatGPT, Perplexity und Gemini heute über deine Marke machen und auf welche Quellen sie sich stützen? Im siebentägigen Test ohne Kreditkarte zeigt dir Alexandrya.AI an deinen eigenen Prompts das Sentiment je Kategorie mit Belegzitat und Plattform, für deine Marke und deine Wettbewerber. Sieben Tage kostenlos testen
Häufig gestellte Fragen
Ab welchem Wert ist das Sentiment einer Marke in KI-Antworten gut?
Einen allgemeinen Richtwert gibt es nicht, weil die Werkzeuge unterschiedliche Skalen und Einheiten verwenden. Peec AI schreibt zu seiner Skala von 0 bis 100, dass die meisten Werte zwischen 65 und 85 liegen. Aussagekräftiger ist der Vergleich mit Wettbewerbern im selben Prompt-Set und mit deinen eigenen früheren Snapshots, jeweils je Aspekt und Plattform.
Kann ChatGPT seine eigenen Antworten über deine Marke bewerten?
ChatGPT kann gesammelte Antworten nach einer festen Anleitung klassifizieren, auch solche, die es selbst erzeugt hat. Die Frage „Wie siehst du Marke X?“ ersetzt diese Auswertung nicht, weil sie eine neue Antwort erzeugt, statt die vorhandenen zu bewerten. Trenne deshalb Abfrage und Klassifizierung und prüfe eine Stichprobe der Einstufungen von Hand.
Warum fällt das Sentiment in ChatGPT, Perplexity und Gemini unterschiedlich aus?
Die Plattformen stützen ihre Antworten auf unterschiedliche Quellen. Perplexity sucht bei jeder Anfrage live im Web, Gemini und Google AI Overviews greifen auf den Google-Index zurück, ChatGPT verbindet Trainingswissen mit einer eigenen Websuche. Ein kritischer Testbericht kann deshalb auf einer Plattform die Antwort prägen und auf einer anderen fehlen. Werte das Sentiment je Plattform getrennt aus.
Welche Aspekte gehören in eine Sentiment-Analyse für Marken?
Die Aspektliste folgt den Fragen, die Käufer vor einer Entscheidung stellen. Typisch sind Preis, Produktqualität, Service, Bedienung und Eignung für eine bestimmte Zielgruppe, bei Software kommen Integrationen und Datenschutz dazu. Lege die Liste vor der ersten Auswertung fest und ändere sie nicht zwischen zwei Snapshots, sonst lassen sich die Werte nicht vergleichen.
Woran erkennst du, dass sich das Sentiment wirklich verändert hat?
Eine echte Veränderung zeigt sich zwischen zwei Snapshots, deren Zeiträume sich nicht überschneiden und die beide genug Antworten enthalten. Überlappen die Fenster, stecken dieselben Antworten in beiden Werten. In der eigenen Messung von Alexandrya.AI taucht dasselbe ChatGPT-Zitat in drei Wochen-Snapshots hintereinander auf. Prüfe außerdem, ob sich das Prompt-Set zwischen den Messungen geändert hat.
Mit welchen Kosten rechnest du für eine automatisierte Sentiment-Messung?
Alexandrya.AI kostet 79, 199 oder 399 Euro im Monat für 50, 150 oder 350 täglich abgefragte Prompts, Enterprise wird individuell vereinbart. Die Brand Perception mit Kategorien, Sentiment, Strengths, Gaps und Belegzitaten ist Teil des Sichtbarkeits-Dashboards. Starter, Professional und Business lassen sich sieben Tage ohne Kreditkarte testen, bei jährlicher Zahlung sinkt der Preis um rund 15 Prozent.
Wie sichtbar ist deine Marke in der KI?
Teste Alexandrya.AI 7 Tage kostenlos und sieh, wie ChatGPT, Gemini, Perplexity, AI Overviews und Copilot über deine Marke sprechen.
- 7 Tage kostenlos
- Keine Kreditkarte nötig
- Voller Funktionsumfang
- Jederzeit kündbar
Über den Autor
Talaal Max Habib
Geschäftsführer Alexandrya.AI
Talaal Max Habib berät seit 2015 Unternehmen aus Industrie, Mittelstand und E-Commerce zu SEO und Generative Engine Optimization. Mit seinem Team hat er Alexandrya.AI entwickelt, die Plattform aus München, die misst, wie Marken in ChatGPT, Perplexity und Gemini erscheinen.
LinkedIn